转载:小红书 AI产品赵哥
前言 🔖
在之前的笔记里,咱们聊了 RAG,聊了缓存。很多人问我,你反复提到的向量数据库,能不能展开讲讲?
如果说大语言模型是 AI 的大脑,向量数据库就是 AI 的第六感。
你有没有想过:
- 为什么在购物网站搜 “蓝色碎花连衣裙”,它会给你推荐 “天蓝色小雏菊短裙” 和 “藏青色印花长裙”?明明关键词不完全匹配
- 为什么音乐 App 能在你听完一首民谣后,精准推荐风格相似但你从未听过的歌?
- 为什么 AI 绘画工具能看懂一张照片,然后画出风格迥异但内容相关的图片?
这些都离不开向量数据库。
别被 “数据库” 三个字劝退。它跟你听过的 MySQL、Oracle 不是一码事儿。今天,咱们一起来聊聊向量数据库,以及它是怎么在大模型的运转中发挥作用的。
一、传统数据库遇到的问题 🔖
认识新朋友之前,先看看老朋友 —— 传统数据库,比如 MySQL、SQL Server。可以把它想象成一个管理得井井有条的超大的档案柜,核心工作方式是精确匹配。
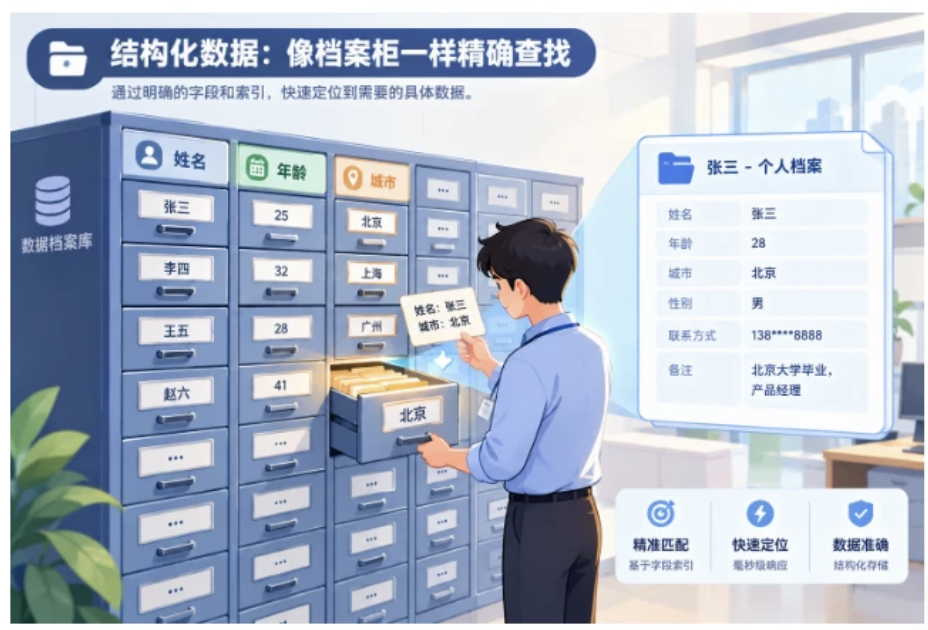
结构化数据:像档案柜一样精确查找 通过明确的字段和索引,快速定位到需要的具体数据。
想找数据,必须给它非常明确的指令:
WHERE 姓名 = '张三'
WHERE 年龄 > 30
WHERE 城市 = '上海' AND 订单金额 > 1000
它只能理解 “是” 或 “不是”、”大于” 或 “小于” 的刚性逻辑。能帮你找到所有姓张、年龄 31、住在北京的人。
但如果你问它:”帮我找和张三气质最像的人”,它会瞬间宕机。它会一脸懵逼地看着你:”气质” 是什么?怎么衡量?表格里根本没有这一列啊!
这就是传统数据库的局限。它擅长处理结构化的、可以精确描述的数据(文字、数字、日期),但对于非结构化的、充满模糊性的数据(图片、音频、”忧郁” 这样的文字描述),它就无能为力了。它无法理解 “相似”、”接近”、”风格类似” 这种基于语义的含义。
而我们今天的 AI 时代,是非结构化数据的时代。互联网上 80% 以上的数据都是图片、视频、文本、语音。AI 的核心任务之一,就是理解和处理这些模糊的数据。
所以,我们需要一种全新的数据库,一种能够理解意义和相似度的数据库。咔嚓一声巨雷,向量数据库诞生了。
二、向量:万物的 “意义坐标” 🔖
要理解向量数据库,必须先搞懂它的核心元素 —— 向量。
向量这个词听起来很数学,但你可以把它理解成一个事物的 “意义坐标”。它是一串用来描述某个对象特征的数字,由叫做 Embedding Model 的特殊 AI 模型生成。
🔹2.1 万物皆可向量化
想象一个超级品鉴师(其实就是 Embedding Model),它的工作是给世界上任何东西打分,打分维度非常奇特,多达几百甚至上千个。
- 品鉴一杯草莓奶昔:品鉴师尝了一口,在一张超长的打分表上写下一串数字:
[甜度:0.9,冰凉感:0.8,奶味浓度:0.7,水果风味:0.95,酸度:0.1,热量感:0.4,…]。这串数字就是草莓奶昔的向量。 - 品鉴一个词语开心:
[正面情绪:0.98,负面情绪:0.01,强度:0.8,与'喜悦'关联度:0.9,与'悲伤'关联度:-0.9,…]。这就是开心的向量。 - 品鉴一张小狗在草地上奔跑的图片:
[动物元素:0.9,自然场景:0.8,动态感:0.7,室内元素:0.05,包含'猫':0.01,色彩'绿色'占比:0.6,…]。这就是图片的向量。
🔹2.2 向量的魔力:距离代表意义
经过品鉴师的打分,所有事物都被映射到一个高维空间里。你可以把它想象成一个 “语义宇宙“。
在这个宇宙里,每个事物都是一颗星星,它的向量就是坐标。这个宇宙的法则:在空间中距离越近的星星,意义越相似。
- “草莓奶昔” 和 “芒果冰沙” 的坐标会离得很近,因为都是冰凉的水果饮品。但它们离 “红烧肉” 的坐标非常远。
- “开心”、”喜悦”、”兴奋” 的坐标聚集在一起,形成 “积极情绪” 星云。而 “悲伤”、”忧郁”、”沮丧” 在宇宙另一端抱团。
- 一张 “白色小猫” 的图片,和 “银色小猫” 的图片挨得很近,但和 “黑色大狗” 的图片相距甚远。
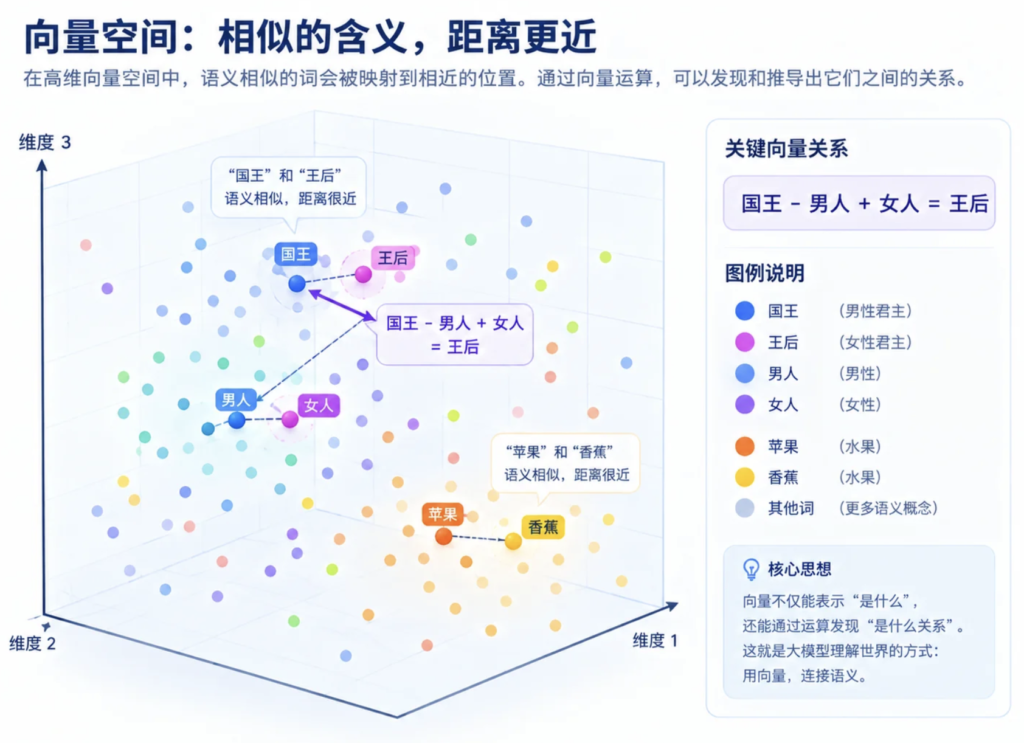
向量是 AI 用来理解世界的数学语言。它把模糊的语义相似度问题,转化成了可以被精确计算的空间距离问题。
向量数据库,就是专门为存储、管理和计算这些 “意义坐标” 而生的。
三、向量数据库的核心两件事儿:索引与搜索 🔖
现在有了成千上万个事物的意义坐标,需要一个地方存储并能快速找到想要的。这就是向量数据库。
可以把它想象成语义宇宙的 “星图管理员”,核心工作就两件事:
🔹3.1 建立索引 —— 绘制高效的宇宙星图
假设有 10 亿张图片,意味着 10 亿个向量。如果让你找和某张新图片最像的 10 张,最笨的办法是把新图片的向量和那 10 亿个逐一计算距离,然后排序。这叫暴力搜索。数据量小的时候还行,一旦上到百万、千万级别,计算量会让任何计算机崩溃。
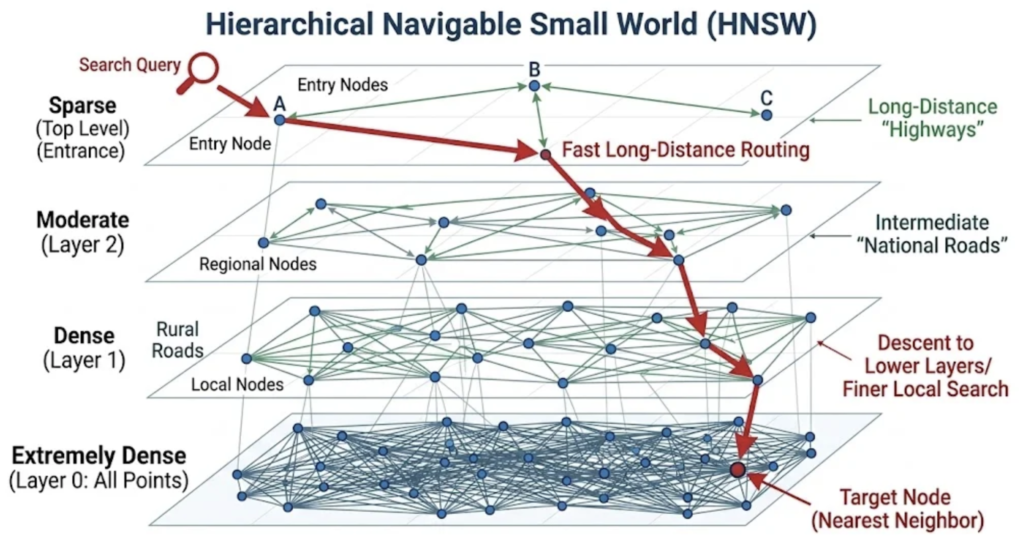
所以向量数据库不会乱糟糟堆在一起,而是预先建立高效的索引。
这个过程就好像在绘制一张分层次、有结构的宇宙星图。它会预先对星星进行分区和聚类:
- 这一大片星云,主要是关于 “动物” 的;
- 在那片星云里,这个小角落是关于 “猫科动物” 的;
- 在猫科动物的角落里,这几颗星星都代表着 “橘猫”
它用了各种复杂但高效的算法(比如 HNSW、IVF、LSH 等),来构建这种层级结构。这就像为宇宙建立了一套高速公路网。
有了这个索引,搜索时不用跟每一颗星星比对距离。
🔹3.2 近似最近邻搜索(ANN)—— 在星图中光速导航
当一个查询请求进来时,向量数据库执行以下操作:
- 查询向量化:把这个新的查询请求通过 Embedding 模型变成一个向量 —— 一颗新的星星;
- 启动 ANN 搜索:拿着新星星的坐标,在建好的宇宙星图上开始导航。它会利用高速公路网,而不是暴力搜索
- 从最顶层的稀疏网络开始,快速定位到离新星星最近的几个大星区;
- 进入这些星区,在更密集的网络中进一步缩小范围;
- 层层递进,最终在最底层的密集网络里,找到和新星星距离最近的 K 个邻居(K-Nearest Neighbors,K-NN)
这叫近似最近邻搜索(ANN,Approximate Nearest Neighbor)。
为什么叫近似?因为为了追求极致速度,牺牲了一点点的精确性。它找到的结果可能是 99.99% 准确的最邻近,而不是 100% 绝对的最邻近。但在绝大多数 AI 应用场景里,这点微小牺牲换来成千上万倍的速度提升,完全值得。
这就好比找离你最近的咖啡店,你不会用尺子测量全城所有咖啡店的精确距离,而是打开地图 App,它会快速给你推荐附近的那几家。可能有一家在小巷子里比推荐的还近 10 米,但 App 推荐的结果已经足够好,而且快得多。
四、向量数据库的用武之地 🔖
理解了向量数据库的工作原理,再看文章开头的那些问题,就会豁然开朗。
🔹4.1 以图搜图 / 智能搜索
- 准备工作:电商平台提前把数百万件商品的图片和描述文字全部变成向量,存入向量数据库,并建立好索引;
- 用户搜索:上传一张 “蓝色碎花连衣裙” 的图片或输入文字。系统立刻把查询也变成向量;
- 搜索过程:向量数据库执行 ANN 搜索,在商品库中找出与查询向量距离最近的 N 个商品向量;
- 结果呈现:这些被找到的商品,就是语义上与 “蓝色碎花连衣裙” 最相似的,即使标题里没有这些词;
🔹4.2 推荐系统
- 用户画像:音乐 App 里听过、收藏过的每一首歌都会被向量化。这些向量的平均值或加权平均值,构成你的音乐品味向量;
- 推荐过程:App 拿着你的品味向量,去曲库(一个巨大的向量数据库)里进行 ANN 搜索,找出和你品味最接近的歌曲;
- 结果:推荐系统有时候比你自己还懂你。你喜欢的每一个内容,都在无形中塑造了你在语义宇宙中的坐标;
🔹4.3 RAG
这是之前讲过的重点。RAG 的核心就是给大模型一个外部知识库,这个知识库就是一个向量数据库。
- 知识入库:把公司所有文档、PDF、网页切块后全部 Embedding,存入向量数据库;
- 问答过程:提问时,问题被向量化,然后去向量数据库里检索出最相关的几个知识片段;
- 生成答案:大模型参考着这些精准的、实时的知识片段来生成答案,避免胡说八道;
🔹4.4 更多应用
- 人脸识别 / 声纹识别:脸部特征或声音特征被提取成向量,验证时用当前特征向量去数据库比对;
- 异常检测:正常交易行为或网络流量形成一个密集的 “正常星云”,任何一个远离这个星云的 “孤立星星” 会被立刻识别并报警;
- 药物发现:将分子结构向量化,科学家可以快速在海量化合物数据库中寻找与某种已知有效药物结构相似的新化合物,加速新药研发;
只要一个场景需要处理和比较非结构化数据的 “相似性”,那里就是向量数据库的用武之地。它已经成为 AIGC 时代不可或缺的基础设施。
五、向量数据库的江湖 🔖
随着 AI 的火爆,向量数据库成了炙手可热的赛道,涌现出许多优秀产品:
🔹5.1 开源新贵
- Milvus:中国团队打造,目前最流行、生态最成熟的开源向量数据库之一;
- Chroma DB:以 “为 AI 而生” 的理念和对开发者友好的特性快速崛起;
- Qdrant、Weaviate:也很受欢迎,各有侧重。
🔹5.2 商业闭源 / 云服务
- Pinecone:向量数据库领域的独角兽,以极致性能和易用的云服务著称;
- Zilliz Cloud:Milvus 的商业化公司提供的云服务,提供企业级支持;
- 各大云厂商:AWS、GCP、Azure 等也在自己平台上集成了向量搜索功能。
🔹5.3 传统数据库的向量化
PostgreSQL(通过 pgvector 插件)和 Elasticsearch 也增加了对向量搜索的支持,试图在原有基础上扩展新能力。
这个领域的竞争非常激烈,但对开发者和用户来说是好事,意味着有更多、更好、更便宜的选择。
六、向量数据库的挑战与未来 🔖
虽然向量数据库很强大,但它也不是解决所有问题的万能药。
维度灾难
为了更精确地描述事物,Embedding 模型生成的向量维度越来越高(从 128 维到 1536 维甚至更高)。维度越高,空间越空旷,计算距离的成本和难度呈指数级增长。”近” 和 “远” 的概念也变得更模糊。这是向量搜索领域持续的理论挑战。
成本问题
向量索引通常需要消耗大量内存(RAM),而内存是昂贵的。对于动辄上亿、上十亿向量的超大规模场景,如何平衡成本和性能,是非常现实的工程问题。
准确性与速度的权衡
ANN 搜索本身就是一种权衡。索引建得越复杂,搜索可能越快,但索引本身占用的空间和构建时间就越长。搜索时召回的候选集越大,结果越准,但速度越慢。如何根据业务需求调整参数找到最佳平衡点,需要丰富的经验。
生态与易用性
向量数据库仍然是较新的领域。如何让它更好地与现有数据系统集成,如何为 AI 开发者提供更流畅的开发体验,是所有厂商都在努力的方向。
未来的向量数据库,一定会朝着更智能、更便宜、更自动化的方向发展。比如能够根据数据分布自动优化索引、支持文本和图片等多模态向量的混合搜索、与大模型更深度融合等等。