转载:小红书 AI产品赵哥
前言 🔖
大家用 AI 聊天、AI 绘画的时候,有没有这种感觉:
- 有时候问一个问题,AI 嗖一下就答了,快得像闪电;
- 有时候同样问问题,它吭哧半天,让你等到花儿都谢了。或者免费额度用得特别快,没聊几句账单爆了。
这背后是咋回事?是 AI 心情不好故意磨洋工?还是网速问题?其实都不是。很可能跟一个概念有关 —— 缓存(Cache),以及缓存命中(Cache Hit)。
咱们再来看看 deepseek-v4-pro 的 token 售价:
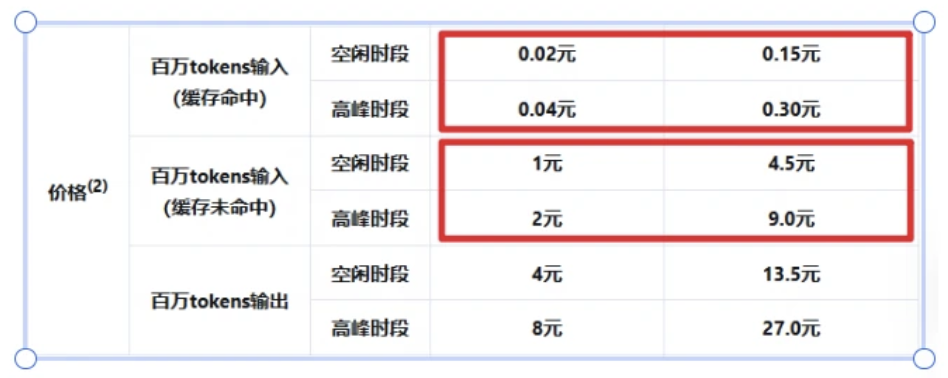
为啥缓存命中和未命中价格差了 50 倍之多?缓存到底是什么东西?今天咱来聊聊。
一、啥是缓存和缓存命中? 🔖
要理解缓存,咱们先忘掉 AI,忘掉代码,看个日常场景。
你公司楼下有家常去的咖啡店,咖啡师叫阿强,记性超好。
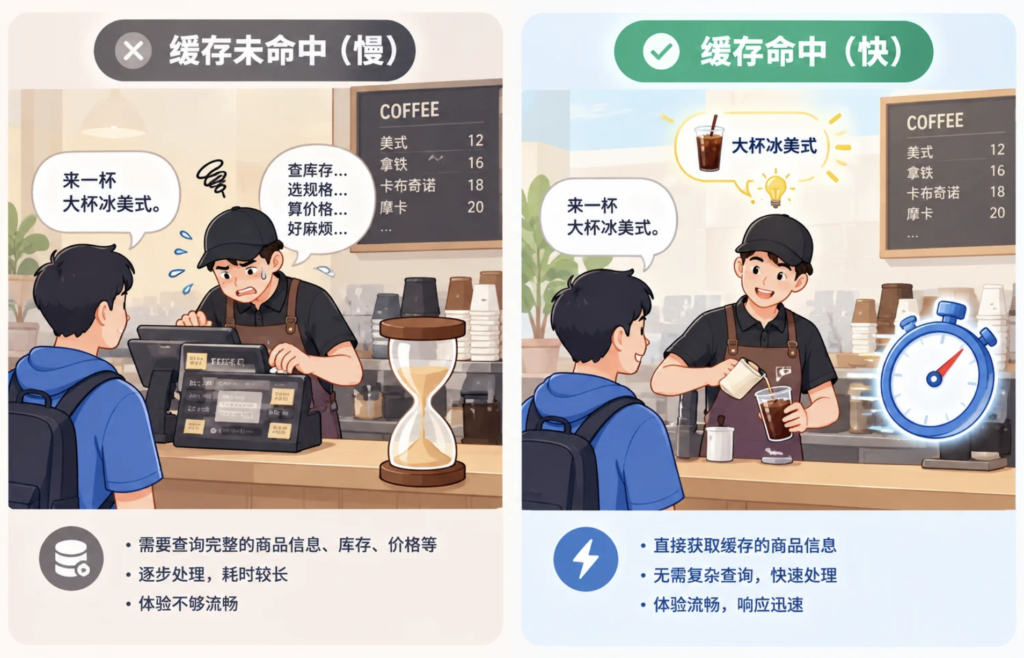
- 第一天,你进店说 “大杯冰美式,不加糖”。阿强不认识你,在 POS 机上一步步操作:选饮品 → 选杯型 → 选冰量 → 选甜度 → 下单。这个过程大概 30 秒。
- 第二天,你又去了,说同样的话。阿强有点印象,但不太确定,又在 POS 机上操作了一遍。
- 连续一周后,你成了熟客。推门进来,阿强不等你开口就开始做那杯 “大杯冰美式,不加糖”,同时打招呼:”今天也这么早啊!老样子?” 你点头,扫码付款,整个过程可能只需要 10 秒。
重点来了:
- 阿强的大脑就是缓存(Cache)—— 小容量但读取速度极快的记忆存储区。
- POS 机就是主存储(Main Memory)—— 记录所有饮品配方,功能全、容量大,但操作相对慢。
当你进店,阿强直接从脑子里调出你的订单,这叫缓存命中(Cache Hit)。从快速的大脑缓存里找到数据,流程就快。
前几天阿强记不住你,必须去操作慢的 POS 机查,这叫缓存未命中(Cache Miss),或缓存穿透。没在缓存里找到,只能去访问慢速的主存储,效率就低。
缓存的核心思想:把最常用、最热门的数据放在访问最快的地方,避免每次都去访问那个容量大但速度慢的主仓库。
这个思想在计算机世界到处都在用。手机 App、电脑操作系统、网站服务器,都有缓存。目的就一个:用空间换时间,提升效率。
二、AI 为什么要用缓存? 🔖
理解了咖啡师的例子,回到 AI。缓存对大语言模型为什么重要?主要原因两点:
🔹1. AI 的 “主存储” 太慢太贵
让 GPT-5.1 这样的大模型完整推理一次,调动的计算资源是海量的 —— 成千上万的 GPU,天文数字级别的数学运算,才能生成你看到的答案。
可以类比:不是去 POS 机点单,而是去后厨从和面、发酵、烘焙开始,从头做一个面包。
这个过程耗时从几秒到几十秒,而且非常耗电、耗计算资源。在云服务上,每一次这样的完整计算都对应着实打实的费用。对提供 AI 服务的公司来说,就是白花花的银子在烧啊烧。
🔹2. 用户的很多请求是重复的
无论是企业客服机器人,还是公开搜索引擎,用户提问往往有很高重复性:
- “如何修改密码?”
- “退货政策是什么?”
- “今天北京天气怎么样?”
- 甚至 AI 绘画里,很多人都会用 “masterpiece, best quality” 这类高频词。
如果没有缓存,每一次重复提问 AI 都要把那个昂贵又漫长的从头做面包过程再走一遍。这不仅考验用户耐心,更消耗公司钱包。
所以为 AI 系统引入缓存,是所有 AI 服务提供商的必然选择。
缓存命中,AI 可以直接跳过昂贵计算,像那个聪明的咖啡师一样从记忆里拿出已经准备好的答案。
好处显而易见:
- 对用户:响应速度快,体验好;
- 对公司:大幅降低 GPU 使用率,节省算力成本。一个高命中率的缓存系统,一年能省几百万甚至上千万。
三、AI 的花式缓存 🔖
缓存的应用比咖啡师记订单复杂得多,发展出了各种玩法:
🔹1. 常规缓存(Standard Cache)
像咖啡师记住 “张三喜欢大杯冰美式”。AI 把问题原文(Prompt)作为 Key,答案(Response)作为 Value 存进缓存。
下次有完全相同的问题,直接返回缓存答案,不用调用模型。
- 优点:实现简单,对完全相同的请求效果立竿见影;
- 缺点:死板。用户改一个字,比如 “北京天气如何” 变成 “北京今天天气如何”,缓存就失效了。
🔹2. 语义缓存(Semantic Cache)
解决常规缓存死板问题的进阶玩法。
不再机械比对文字是否一样,而是用 Embedding 技术判断两个问题意思是否相似。
流程是这样的:
- 新问题进来,先向量化,变成 “语义坐标”;
- 拿这个坐标去缓存库(也是向量数据库)搜索,找意思接近的已缓存问题;
- 找到相似度超 99% 的问题(比如 “如何重置密码” 和 “我忘记密码了怎么办”),就返回已存答案;
语义缓存让 AI 的记忆更聪明,不是死记硬背,而是理解问题核心含义。缓存命中率大大提高。
🔹3. KV 缓存(Key-Value Cache)
这是 LLM 内部的核心缓存机制,让 GPT 能流畅对话、快速生成长文。
用比喻理解: 写一篇长文章,写下第一句 “今天天气真不错”,大脑对这句话进行了处理理解,形成上下文语境。写第二句 “我们一起去公园散步吧” 时,不需要从头回味第一句的每个字怎么写、语法是什么 —— 大脑会自动利用已有语境,直接在此基础上构思下一句。
LLM 生成文本也是如此,是自回归模型,生成下一个词依赖前面所有已生成的词。
比如生成 “今天天气真不错,我们去”:
- 先生成 “今天”
- 根据 “今天” 生成 “天气”
- 根据 “今天天气” 生成 “真不错”
- 以此类推
每生成一个新词,都要过一遍脑子前面所有内容。句子长了,重复计算量巨大。
💡 KV 缓存把处理前面内容时计算出的中间结果(Key 和 Value,注意力机制核心产物)缓存起来。生成下一个词时,不需要从头计算,直接加载缓存的中间结果,只对最后一个词计算。
相当于给模型装了个短期记忆,让它连续生成文本时不用每次都从我是谁我在哪开始,能记住刚想到哪了。
KV 缓存极大提升了 LLM 处理长文本、多轮对话时的生成速度。用 ChatGPT 连续对话感觉能秒回,很大程度上就是 KV 缓存的功劳 —— 它缓存了之前对话历史的计算结果,所以能快速接着说。
🔹4. Embedding 缓存
这个我们昨天讲的 RAG 里也有应用。将文本向量化的过程本身也需要计算。对大型知识库,每次检索都重新计算 Embedding 会很耗时。所以通常提前把所有文本块的 Embedding 计算好缓存起来(存向量数据库),这也是典型缓存应用。
四、缓存的烦恼与挑战 🔖
说了这么多缓存好处,也要看看缓存有啥问题:
🔹1. 缓存容量有限
咖啡师脑容量有限,不可能记住所有顾客偏好。缓存通常是内存,昂贵且有限。缓存满了,就得丢掉旧数据为新数据腾地方。
🔹2. 缓存淘汰策略
该丢哪些数据?这就是淘汰策略要解决的问题。常见策略:
- LRU(最近最少使用):优先忘记一个月没来的顾客订单;
- LFU(最不经常使用):忘记只来过一次、点了杯白开水的顾客;
- FIFO(先进先出):不管熟不熟,忘记最早记住的顾客订单;
选哪种策略要根据业务场景来定,需要权衡。
🔹3. 缓存一致性问题
这是最头疼的问题。
比如你这个老顾客今天想换口味,不喝冰美式想喝拿铁,但咖啡师已经缓存命中,飞快做好冰美式递过来 —— 尴尬了,缓存数据(冰美式)和真实数据(你想喝拿铁)不一致。
AI 系统也一样。查询 “我们公司股价” 的请求被缓存了,第二天股价变了,缓存不更新的话,AI 就给用户过时答案。
如何及时让缓存失效或更新(Cache Invalidation),确保数据一致性,其策略是设计缓存系统的核心挑战。
五、总结:吃透今天的知识点 🔖
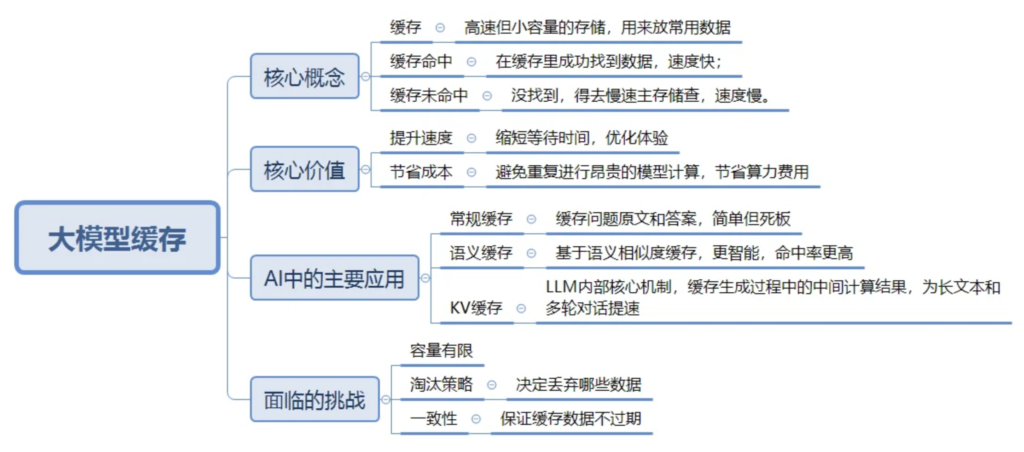
好了,今天的硬科普时间差不多了。我们用一张思维导图来总结一下缓存命中这个知识点: