转载:小红书 AI产品赵哥
前言🔖
今天聊一个看似矛盾、但每天都在发生的现象。
- 一方面,新闻里说 GPT-5 有上万亿个参数,训练一次烧掉几千万美金,需要一个数据中心那么大的服务器集群才能跑。
- 另一方面,你手机相册里的人像模式能瞬间把背景虚化得像单反拍的;语音助手离线也能听懂你的指令;现在你已经可以在自己的笔记本上流畅运行一个几十亿参数的开源大模型。
那些庞大如山的模型,是怎么被压缩塞进这些小设备里的? 答案就藏在今天的主角 —— 模型量化之中。
说人话:模型量化是一套给 AI 模型极限压缩的技术。它能让模型体积缩小好几倍,运行速度提升好几倍,而精度只出现轻微、甚至可以忽略的下降。 今天咱来看看这个量化是个什么东西。大家准备好,咱们就发车了!!!
一、AI 模型咋得了肥胖症?🔖
咱先来看看,模型为什么会这么胖?
一个深度学习模型,本质上是一个极其复杂的数学函数,核心由成千上万甚至数万亿个参数组成。这些参数就像神经元连接的权重,记录了模型从海量数据中学到的所有信息。
训练时,计算机为了尽可能精确地表达这些知识,会用非常高精度的数字格式存储参数,最常见的就是 32 位浮点数(FP32)。
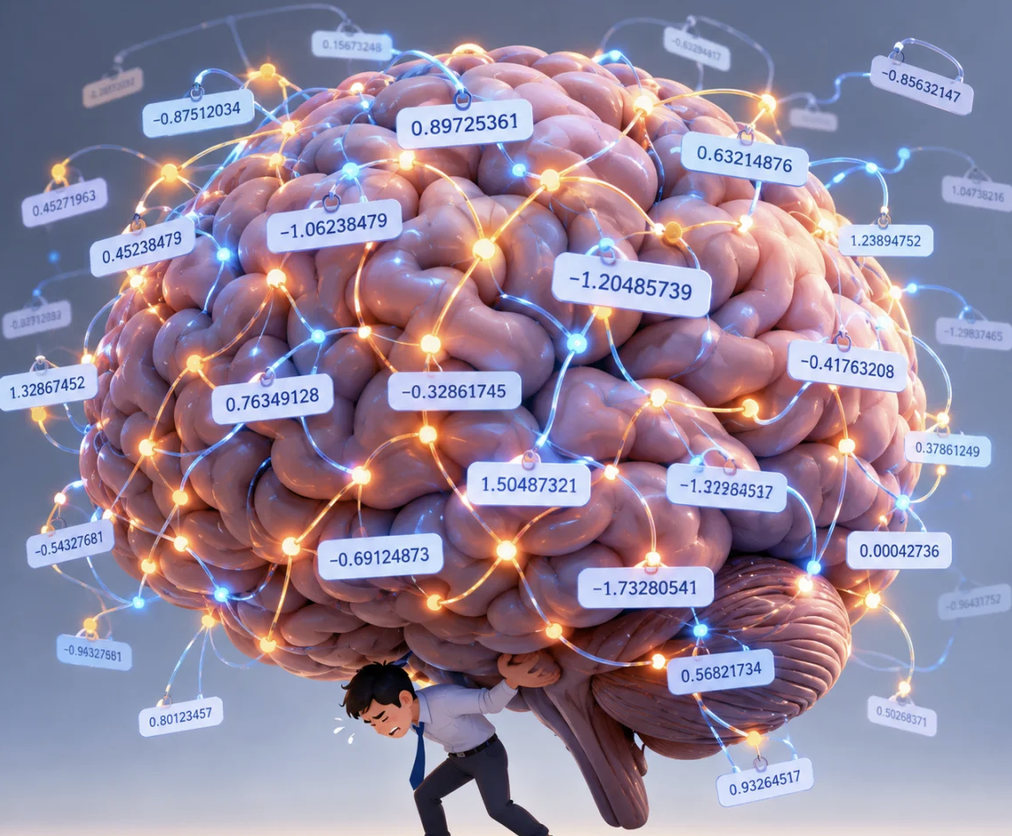
FP32 的优点是精度极高,能表示非常大范围和非常精细的小数,保证模型在训练过程中充分学习。
缺点也很致命:
- 太占地方:每个参数占 32 比特(bit)。一个 70 亿(7B)参数的模型,光存储参数就需要 70 亿 × 32 bits / 8 ≈ 28 GB。你手机内存才多大?这还没算运行时的额外开销。
- 太耗精力:计算机处理两个 32 位数字做乘加运算时,需要调动更多计算单元和时间。这就好比心算 12.3456 × 78.9012 肯定比 12 × 79 慢得多。模型每生成一个词都涉及数万亿次浮点运算,速度自然快不起来。
- 太费电:复杂计算和巨大的数据搬运意味着更高的能量消耗。对手机、无人机、智能手表这类电池供电的设备来说,这是无法接受的硬伤。
所以未经优化的 AI 模型,就像一个很聪明但体型臃肿、行动迟缓、饭量还贼大的胖子。把它直接部署到手机、汽车、摄像头这类资源受限的端设备上,完全不现实。
量化因此而诞生。目标只有一个:在尽可能不影响模型能力的前提下给它减肥减负,让它更小、更快、更省电。
二、量化的核心方法:一把精度换速度的尺子🔖
核心思想其实很朴素,是一种权衡(Trade-off)。
打个比方就懂了:假设你是个 NB 的建筑师,手里有一把刻度精确到微米的瑞士精钢尺。用它测量大楼高度,得出 125.678912 米。
但问题来了:
- 这把尺子太重,背着它跑上跑下很累(计算慢);
- 太金贵,保养和携带成本很高(硬件贵);
- 你把 125.678912 米报给施工队,他们也用不上这么高精度,可能只需要知道大概 125.7 米,或者干脆 126 米就够了。
这时候你换了一把普通塑料学生尺,精确到厘米,量出来是 125.7 米。
再极端一点,换一把只有米刻度的卷尺,量出来是 126 米。这把尺子就代表着量化后的低精度数字,比如 8 位整数(INT8)。
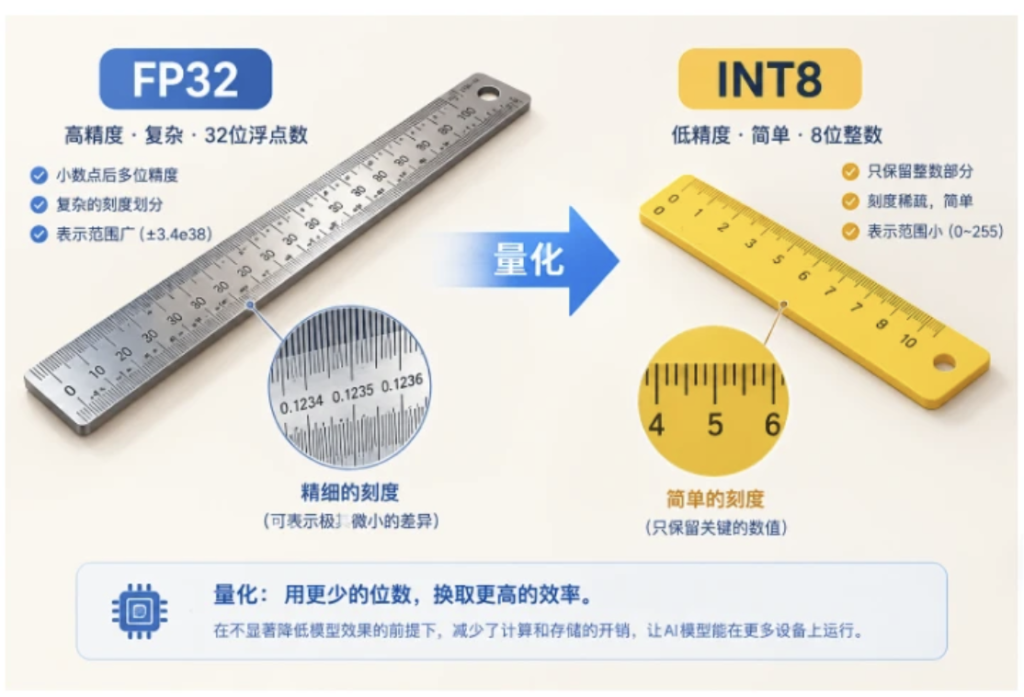
所以,虽然塑料尺和卷尺的精度远不如那把瑞士钢尺,但对 “测量大楼高度” 这个任务来说,好处显而易见:轻便、便宜,而且结果已经足够好。
模型量化做的是同样的事:把模型中用高精度 FP32 表示的参数,用一种没那么精确但足够用的低精度数字(比如 INT8)来近似表示。
💡 这就是精度换速度的核心思想:牺牲一点点几乎用不上的理论精度,换来体积、速度和功耗上的实质收益。
三、从 FP32 到 INT8 🔖
接下来,咱们一起看看技术上具体怎么操作的。
🔹数字的占地面积
- FP32:标准高精度浮点数,每个数字占 32 bit,可表示范围极大,精度非常高。这是训练时的黄金标准;
- FP16:半精度浮点数,占 16 bit,面积是 FP32 的一半。范围和精度都有所下降,但通常够用;
- INT8:8 位整数,占 8 bit,面积是 FP32 的四分之一。它只能表示 \(2^8 = 256\) 个整数,通常是有符号的 [-128, 127] 或无符号的 [0, 255]。注意,它没有小数部分;
- 更极端的还有 INT4(4 bit,只能表示 16 个数),甚至 1 bit(二值网络,只能表示 -1 和 1)
从 FP32 到 INT8,模型体积直接缩到原来的 1/4。28 GB 的模型瞬间变成 7 GB。
🔹映射的艺术:如何把小数变成整数
关键问题是:FP32 带小数,INT8 是纯整数,怎么把小数合理地转成整数,同时最大限度保留原有信息?
答案是线性映射(Linear Mapping)。
假设有一堆 FP32 参数,数值范围在 [-1.5, 2.0],想把它们全部塞进 INT8 的 [-128, 127]。
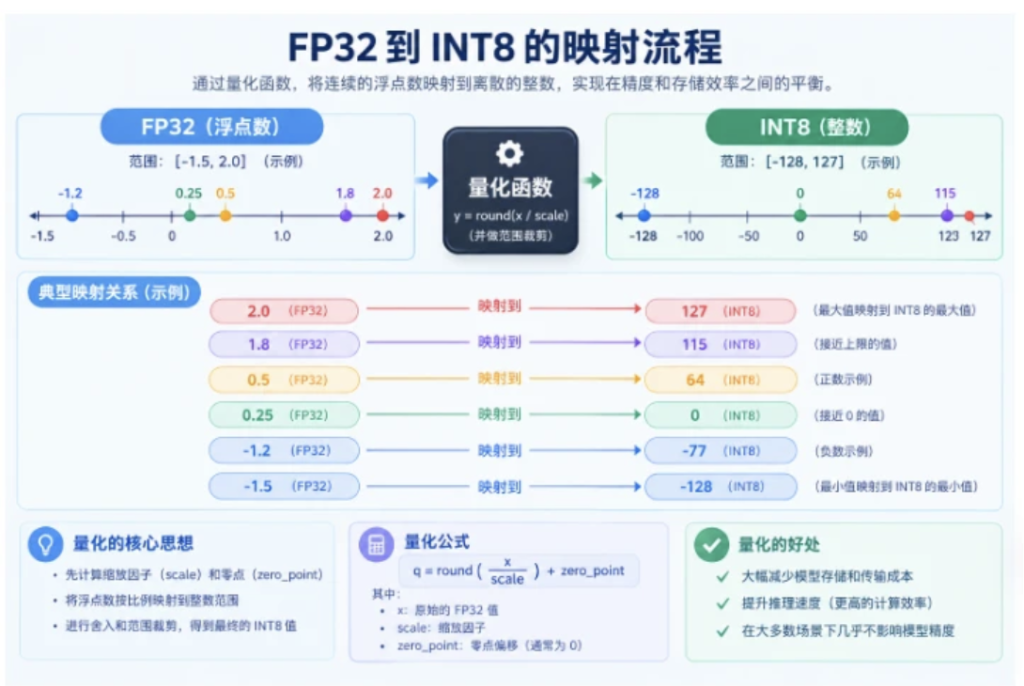
这个映射需要两个关键参数:
- 缩放因子(Scale, S):决定 FP32 世界里的一小步,对应 INT8 世界里的多大一步,可以理解为 “比例尺”。
S = (max_fp32 - min_fp32) / (max_int8 - min_int8)
在例子里,S = (2.0 - (-1.5)) / (127 - (-128)) = 3.5 / 255 ≈ 0.0137。
- 零点(Zero-Point, Z):保证 FP32 世界里的 0 能准确映射到 INT8 世界的某个整数,用来处理非对称的数值范围。
Z = round(max_int8 - max_fp32 / S)
例子里计算稍微复杂些,但本质是找到一个偏移量让 0 对齐。
有了这两个参数,量化过程就很简单:
INT8_value = round(FP32_value / S + Z)
反过来,量化后的模型做计算时,需要把 INT8 结果转回 FP32,这叫反量化(Dequantization):
FP32_value = (INT8_value - Z) * S
所以量化的本质,就是为模型中的每一层(或每一组)参数找到最佳的 S 和 Z,然后用上面那个简单公式完成从 FP32 到 INT8 的转换和存储。模型文件里存的是 INT8 整数和对应的 S、Z 值,体积大大减小。计算时硬件可以直接进行更快的整数运算,从而实现加速。
四、PTQ vs QAT🔖
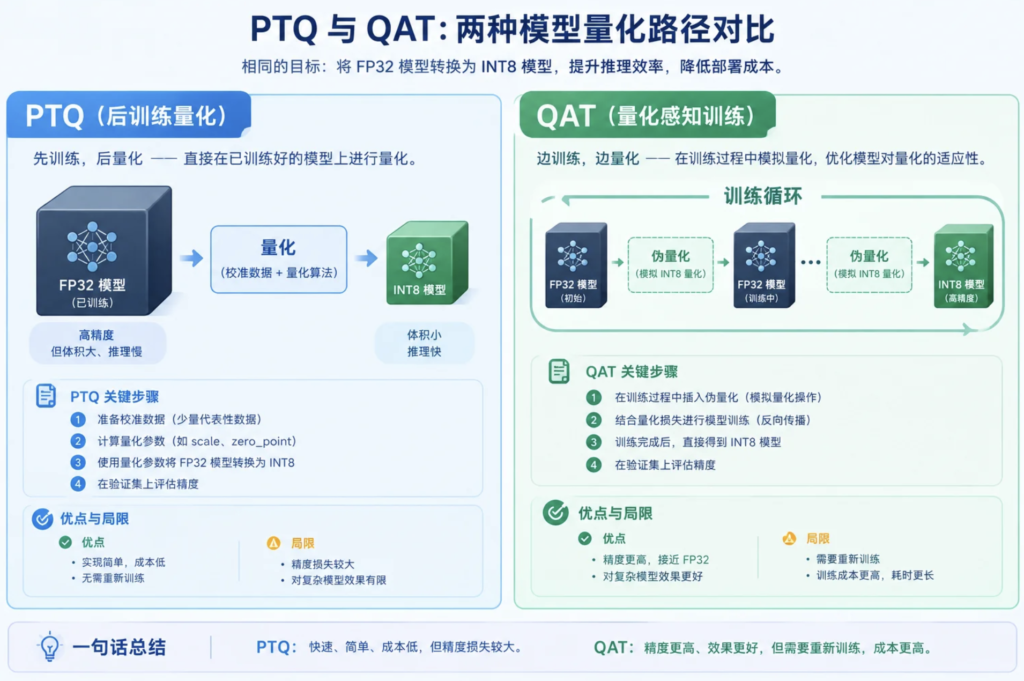
接下来的问题是在什么时候做。根据量化介入的时间点不同,主要分两大流派:
🔹1. 训练后量化(PTQ)
先用 FP32 完完整整训练好一个模型,当成成品,然后再对这个成品做量化。
💡 打个比方:你已经用最高规格的摄像机拍好了一部电影,现在为了能在手机上传播,用一个视频压缩软件把它压成更小的 MP4 文件。
- 优点:
- 简单快捷:不需要重新训练,整个过程几分钟到几小时就能搞定;
- 数据量要求少:只需要一小部分校准数据来计算 S 和 Z。
- 缺点:
- 精度损失可能较大:模型训练时完全不知道自己将来会被压缩,没有为此做准备。这种先斩后奏式的量化可能对敏感参数造成较大误差。
🔹2. 量化感知训练(QAT)
在训练过程中就模拟量化带来的影响。
💡 打个比方:你是一位导演,拍电影时就知道最终会在手机小屏上播放,所以构图打光时刻意避开在小屏上看不清的复杂细节,突出主体。你在为压缩而创作。
工作流程: 在训练的每一步(前向传播)中,都假装把 FP32 参数量化成 INT8,计算损失,再用 FP32 的高精度梯度做反向传播和参数更新。这个过程叫伪量化(Fake Quantization)。
- 优点:
- 精度更高:模型在训练时就学会了适应低精度限制,会自动调整参数让量化误差最小化。QAT 后的精度可以无限接近,有时甚至超过原始 FP32 模型(量化带来了一定的正则化效果,防止过拟合)。
- 缺点:
- 复杂且耗时:需要完整训练流程,对训练代码的修改也更复杂,花费的时间和计算资源远超 PTQ;
- 需要完整的训练数据。
怎么选呢?
- 追求快速上线、对精度下降有一定容忍度,选 PTQ。
- 追求极致性能、精度要求极高、不计较训练成本,选 QAT。
- 实际中往往先用 PTQ 快速验证,精度损失不可接受再上 QAT。
五、量化的优势🔖
体积变小只是开胃菜。真正的威力体现在部署和运行时。
🔹更小的模型体积和内存占用
体积上,从 FP32 到 INT8 变成 1/4,从 FP32 到 INT4 变成 1/8。这让在手机等存储有限的设备上部署大模型成为可能。
内存带宽上,模型运行时需要不断从内存读参数到计算单元。模型变小意味着每次搬运的数据量也变小,大大减轻内存带宽压力,这也是加速的一个重要原因。
🔹更快的计算速度
整数运算比浮点运算快。在绝大多数处理器(CPU、GPU、专门的 AI 芯片 NPU)上,执行整数运算都远快于浮点运算。硬件可以用更简单的电路设计,在同一个时钟周期内完成更多整数运算。
SIMD 指令集方面,现代处理器支持单指令多数据流(SIMD)。一个 128 位的寄存器可以同时装载 4 个 32 位的 FP32 数字,或者 16 个 8 位的 INT8 数字。一条指令能同时完成 16 次 INT8 运算,却只能完成 4 次 FP32 运算,理论上带来 4 倍吞吐提升。
🔹更低的功耗
数据搬运能耗上,芯片上把数据从内存搬到计算单元的能耗往往比计算本身还高。量化减少了搬运量,直接降低这部分功耗。
计算能耗上,整数运算单元的电路更简单,能耗也低于复杂的浮点运算单元。
这三点结合起来,使得量化后的模型能在端设备上实现实时推理,并极大延长设备电池续航。
六、量化存在的问题🔖
听起来这么美好,缺点当然有。最大挑战就是如何控制精度损失。
🔹离群值(Outliers)的挑战
模型参数的分布通常类似正态分布,大部分值集中在 0 附近。但总有一些离群参数,绝对值非常大。
计算缩放因子时用 S = (max - min) / 255。如果 max 因为某个离群点变得特别大,S 也会跟着变大,结果是大部分集中在 0 附近的正常值在量化后都被映射到少数几个整数上,丢失大量细节,严重影响精度。
✅ 解决方案:为离群值单独处理,或者计算 S 时采用 99.9% 分位数而不是绝对最大值,牺牲对极端值的表达来保全大部分值的精度。
🔹逐层量化 vs 逐通道量化
最简单的量化是为每一层找到一组 S 和 Z。但一层之内不同通道的参数分布可能差异巨大,用同一把尺子量,对某些通道合适,对另一些就不合适。
✅ 解决方案:逐通道量化(Per-Channel Quantization),为每一层的每个通道单独计算一套 S 和 Z。这样更灵活、精度损失更小,但计算和存储 S、Z 的开销也随之增加。
🔹对特定任务的敏感性
有些任务对数值精度非常敏感。比如目标检测中的定位,微小误差可能导致定位框巨大偏移。有些模型的特定层,比如 Attention 机制中的 Softmax 计算,对数值范围很敏感。
✅ 解决方案:混合精度量化(Mixed Precision)。不一刀切地全部量化成 INT8,而是对不敏感的层用 INT8,对少数关键敏感的层保留 FP16 甚至 FP32。这种在性能和精度之间取平衡的做法,是一门平衡的艺术。
七、身边哪里有量化?🔖
🔹智能手机
这是量化应用最广泛的领域。
- 人脸解锁需要在 1 秒内完成识别,量化是实现低延迟的关键。
- 相机的人像模式背景虚化、夜景降噪、智能场景识别,背后都是量化后的卷积神经网络(CNN)在实时运行。
- 手机没网时语音助手依然能听懂 “打电话给妈妈”,是因为有个量化后的语音识别模型部署在本地。
🔹笔记本电脑
最近爆火的 Ollama、Llama.cpp 等项目,能让你在自己的 Mac 或 PC 上运行几十亿参数的大模型,核心就是应用了各种激进的量化技术(4 bit、5 bit 量化)。它们把原本需要几十 GB 显存的庞然大物,压缩到普通电脑的内存就能容纳。
🔹智能驾驶汽车
辅助驾驶系统需要实时处理摄像头、雷达等传感器的数据,识别行人、车辆、交通标志。这些模型必须在极低延迟下做出判断,功耗也不能太高。量化是满足这些要求的必备技术。
🔹智能家居设备
智能音箱、智能门铃摄像头内部 AI 芯片上运行的,也都是深度量化后的模型,用来实现低成本和低功耗。