转载:小红书 AI产品赵哥
前言🔖
咱们聊过 Agent 的搭建和多 Agent 系统,今天我们来聊一个 Agent 里的核心话题 —— Agent 的记忆机制(Memory)。
跟早期聊天机器人对话是什么体验?它永远记不住三秒前你说过啥。你上一句说 “我喜欢蓝色”,下一句问它 “我喜欢什么颜色”,它一脸懵逼地回答 “我不知道哦”。
但现在厉害的 AI Agent,比如一些智能个人助理,不仅能记住你几分钟前的对话,甚至能记住你上周、上个月的偏好和习惯。它能记得你对花生过敏,记得你正在追的剧,记得你设定的年度目标。
这一切都归功于记忆机制。记忆让 AI 从一个只会应答的机器,进化成有上下文、懂你心意的智能体。
大家准备好了吗?咱们发车了!
一、为啥 Agent 非得有记忆?🔖
先从最基本的问题开始。想象你新招了一个人类助理,叫小明。
🔹场景一(无记忆的小明):
> 你:"小明,帮我订一张明天上午去上海的机票。"
> 小明:"好的,请问去哪里?"
> 你:"…… 去上海。"
> 小明:"好的,请问什么时间的机票?"
> 你:"明天上午!"
> 你:“明天上午!”
> 小明:“好的,明天上午去哪里的机票?”
你想抄起键盘打人了。这个小明就是没有记忆的 AI,每次只能处理你当前输入的这一句话,完全没有上下文概念。这种 AI 叫无状态(Stateless)的。它就像一个数学函数,你输入 X 它输出 Y,两次独立的输入 X 得到的结果永远一样,跟之前发生了什么毫无关系。
🔹场景二(有记忆的小明):
> 你:“小明,帮我订一张明天上午去上海的机票。”
> 小明:“好的,老板。正在查询明天上午飞往上海的航班。您有偏好的航空公司吗?上次您飞上海选的是东方航空。”
> 你:“这次国航吧,帮我选个靠窗的位置。”
> 小明:“收到!已为您筛选国航航班,并锁定靠窗座位。另外,我记得您提过您对坚果过敏,我会在餐饮备注里加上这一条。”
这个小明不仅记得当前对话,还记得你过去的行为和声明过的个人偏好。
这就是有记忆的 AI Agent。它能够:
- 维持对话连贯性,让对话像流水一样自然进行;
- 理解个性化需求,基于历史信息提供更精准的服务;
- 执行复杂的多步任务,比如规划一次旅行需要记住预算、时间、兴趣点等;
- 从经验中学习和进化,分析过去的交互变得更懂你。
所以记忆赋予了 AI上下文感知能力和个性化能力,使它成为真正能解决问题的智能 Agent。
二、AI 的大脑长啥样?🔖
既然记忆这么重要,AI 的大脑里记忆系统是怎么设计的?不用想太复杂,打个比方就明白了:
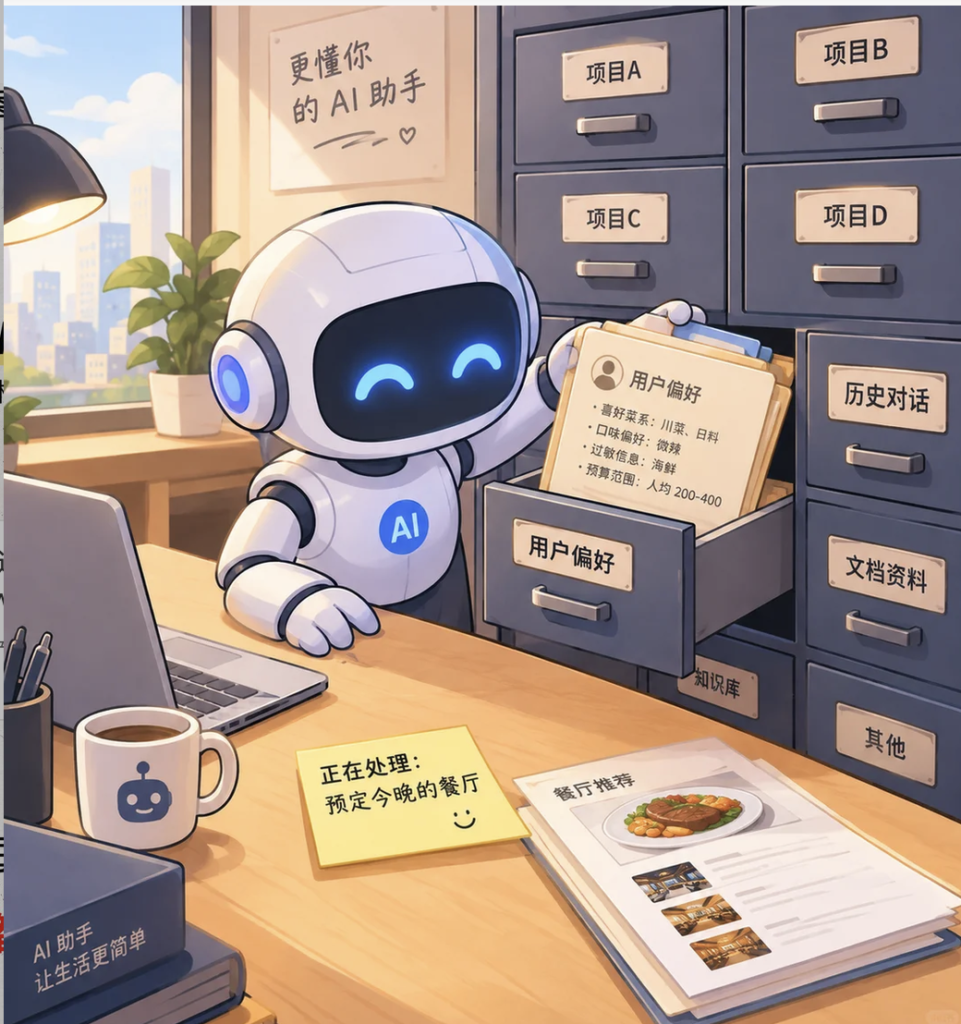
想象一个超级敬业的私人助理,他的办公桌就是 Agent 的记忆系统。
这张图里包含了 AI 记忆的两个核心部分:
- 短期记忆(STM):就像桌上的那张便签纸。用来记录当前正在处理的事情,容量小,随用随扔,但查阅起来非常快。比如你和 AI 正在进行的这场对话、你刚刚提到的要求,都记在这张便签纸上。
- 长期记忆(Long-Term Memory, LTM):就像旁边的那个大文件柜。用来存放所有历史信息,容量巨大,可以永久保存,但查找起来需要一点时间。比如你所有的个人资料、过去的对话摘要、完成的项目文档等,都分门别类地放在这里。
AI Agent 工作时,就是不断在便签纸上涂鸦,同时根据需要去文件柜里翻找旧资料,再把找到的资料抄到便签纸上一并处理。
💡 这里面提到了 Agent 记忆机制的精髓:一种分层的、动态协作的系统。
三、短期记忆的秘密:上下文窗口(Context Window)🔖
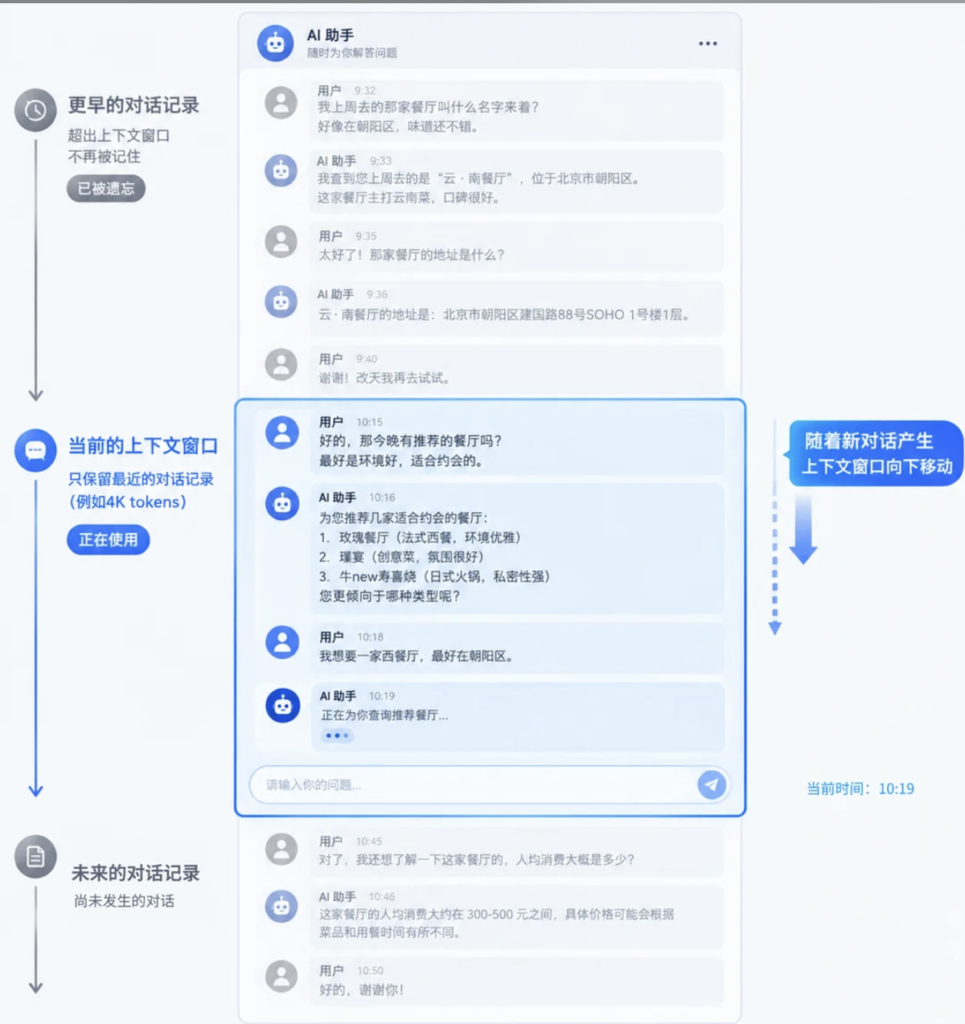
先看最直接的短期记忆。在 AI 领域,短期记忆有一个重要的技术名词:上下文窗口(Context Window)。也就是大模型一次性能看到的文本长度。
当你跟 ChatGPT 对话时,你以为它真的记住了你们的聊天记录?真相是:应用程序在你每次发送新问题时,会把你最新的问题和一部分最近的聊天记录打包在一起,作为完整的文本一次性发给大模型。这个打包后的总长度不能超过模型的上下文窗口限制。
上下文窗口是一个滑动的视野框。模型只能看到这个框里的内容。框外面的,就忘记了。
- 它的单位是什么?
- 通常是 Token。你可以粗略地理解成一个单词或一个汉字。比如一个 4K Token 的上下文窗口,大概能装下几千个单词或汉字。
- 现在有多大?
- 早期模型可能只有 2K、4K。GPT-4 Turbo 有 128K,Google 的 Gemini 1.5 Pro 达到了 100 万 Token,可以一口气读完一部《哈利波特》。
- 越大越好吗?
- 理论上是。更大的窗口意味着 AI 能记住更长的对话、更复杂的文档,不容易失忆。但这也会带来巨大的计算成本,而且信息太多,AI 反而找不到重点。
短期记忆的管理策略
当对话变得很长,快要超出窗口时,怎么办?
- 滑动窗口:保持窗口大小不变,随着对话进行直接丢掉最老的一部分对话。优点是简单,缺点是可能丢失重要的早期信息;
- 截断:保留开头和结尾,丢掉中间部分;
- 对话摘要:更智能的方法。当旧的对话即将被挤出窗口时,系统调用 LLM 把这部分对话生成一个简短的摘要。 a. 比如:”用户和 AI 讨论了去北京的旅行计划,用户偏好经济型酒店,对故宫和长城感兴趣。” 然后这个摘要一直被保留在上下文窗口开头。 这就像读一本很长的书,每读完一章就在扉页写下一句话的章节总结。这样即使忘了具体细节,也能随时回顾故事的主线。
小结:短期记忆是 AI Agent 能够进行连贯对话的基础。它快、直接,但健忘、昂贵。它解决了 “当前任务” 的记忆问题,但无法解决跨任务、跨时间的持久记忆问题。
要实现真正的记忆,必须请出大文件柜 —— 长期记忆。
四、长期记忆:向量数据库(Vector Database)🔖
如果说短期记忆是 AI 的临时工作台,那长期记忆就是 AI 的知识库。
长期记忆的核心思想:把 AI 需要记住的信息从非结构化的文本转换成机器能够理解和检索的格式,存到一个专门的数据库里。
拆解成两个关键技术点:
- 嵌入(Embedding):把文字变成意义坐标;
- 向量数据库(Vector Database):专门存放和检索意义坐标的仓库;
🔹第一步:嵌入(Embedding)—— 语言的数学化
这是整个长期记忆系统的基础。
人类能理解 “国王” 和 “皇帝” 意思相近,和 “汉堡” 意思差很远。但机器看到的是一堆字符编码,它怎么理解 “意思”?
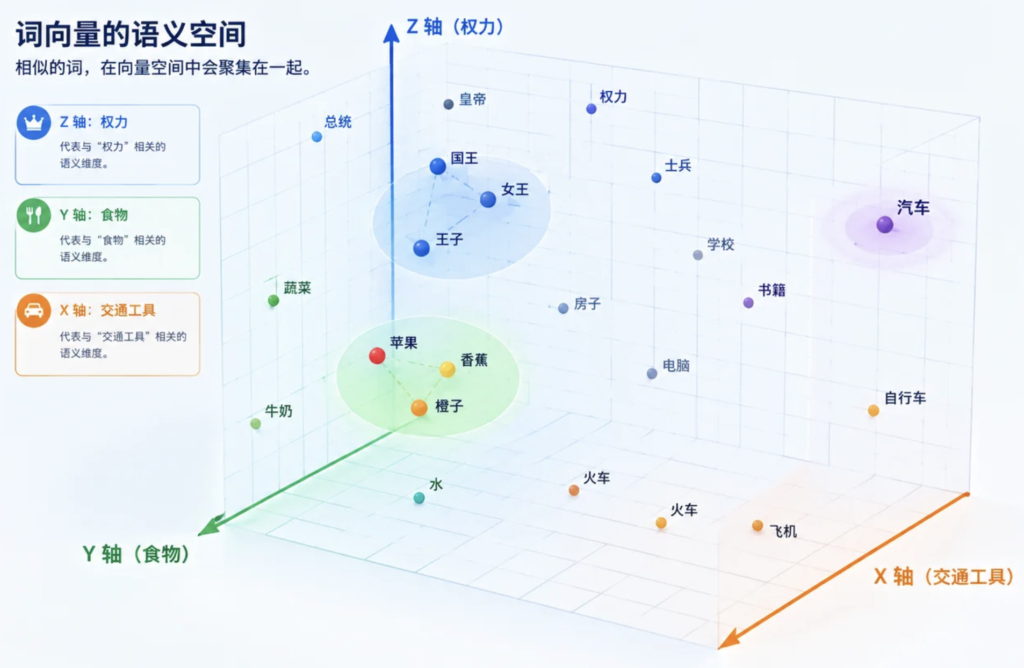
Embedding 技术就是用一个充满数字的列表(向量)来表示一个词、一句话、一段文字的 “语义含义”。
可以把它想象成给宇宙万物在一个高维空间里分配一个独一无二的坐标。
- 语义相近,坐标就相近:”国王” 的向量坐标,会和 “女王” 的向量坐标在空间上非常接近;
- 语义无关,坐标就疏远:”国王” 的向量坐标,会和 “三明治” 的向量坐标在空间上离得十万八千里。
这个转换通过嵌入模型(Embedding Model)完成。这个模型通过在海量文本上进行训练,学会了如何捕捉词语和句子之间的复杂语义关系,并映射到向量空间中。
比如存储这条记忆:”我的生日是 10 月 26 日,我喜欢吃巧克力蛋糕。”
经过 Embedding 模型处理,它就变成了一串类似 [0.12, -0.45, 0.88, ..., -0.23] 这样的数字向量。这个向量就是这条记忆在 AI 大脑中的数学化身。
🔹第二步:向量数据库(Vector Database)—— 记忆的宫殿
好了,现在我们有了一大堆代表着各种记忆的向量坐标,该把它们存到哪里去呢?
普通的关系型数据库(比如 MySQL),擅长的是精确匹配,比如 SELECT * FROM users WHERE name = '张三'。但它没法处理 “找一个跟这个意思差不多的” 这种模糊的语义搜索。
这时候,向量数据库就闪亮登场了。向量数据库,就是一个专门为存储和高效检索高维向量而设计的数据库。它的核心能力,不是精确匹配,而是近似最近邻搜索(Approximate Nearest Neighbor, ANN)。
工作流程:
- 存储:把成千上万条记忆通过 Embedding 转换成向量,全部存进向量数据库。数据库用一些算法(比如 HNSW、IVF-PQ)把这些向量组织起来,方便快速查找。
- 检索:当用户提出新问题时,比如
我快过生日了,有什么好建议吗,Agent 会:- 先把这个问题通过同一个 Embedding 模型转换成查询向量;
- 拿着这个查询向量去向向量数据库里找出坐标最接近的 K 个向量;
- 数据库返回离查询向量最近的记忆对应的原始文本;
看,神奇的事情发生了。AI 并没有进行任何关键词匹配,但它通过比较向量的距离准确地找到了最相关的信息。
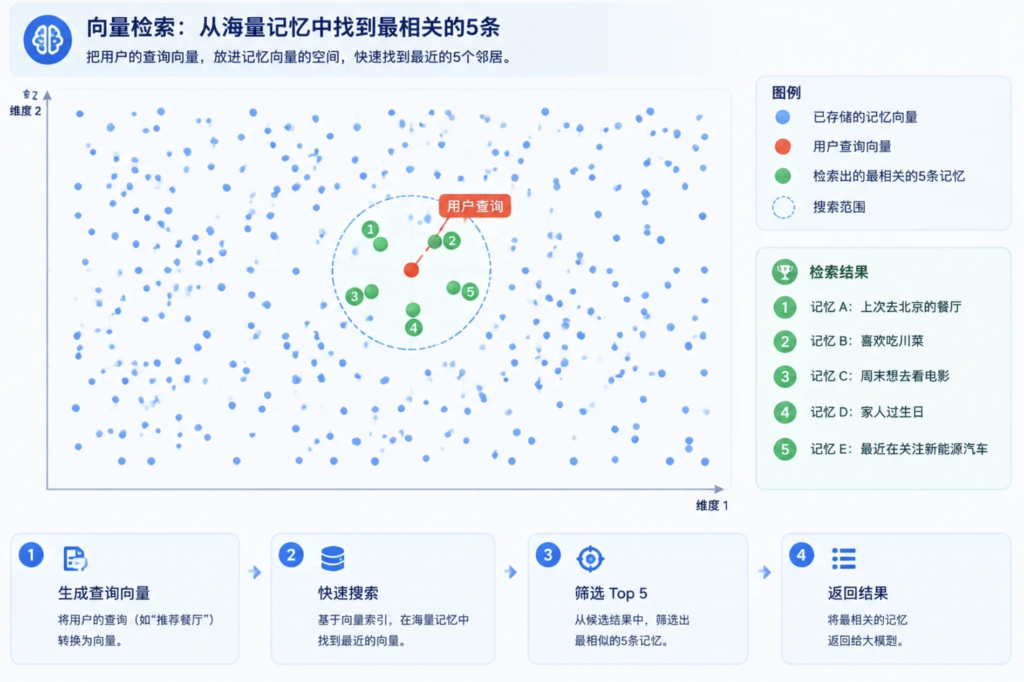
💡 这就是长期记忆的核心机制:将信息向量化存储,通过向量相似度进行语义检索。
市面上流行的向量数据库有 Pinecone、Weaviate、Milvus、ChromaDB。
五、记忆三部曲:存入、提取、精炼 🔖
了解短期和长期记忆的底层技术后,看看成熟的 AI Agent 是如何管理整个记忆周期的。
🔹第一步:记忆的存入 —— 该记下点什么
AI 每天跟我们聊那么多,不能把每句话都存进长期记忆,否则文件柜很快就塞满垃圾。判断策略可以很简单,也可以很复杂:
- 基于规则:包含 “我的偏好是……”、“请记住……” 等关键词的句子自动存入;
- 定期总结:每段对话结束后让 LLM 自动生成摘要存入;
- 基于实体识别:识别人名、地名、日期、目标等作为结构化信息存入;
- Agent 自我决策:更高级的 Agent 在完成任务后自我反思:”这次任务的结论是什么?学到了什么新知识?” 然后把这些感悟存起来。
一旦决定存储某条信息,就启动流程:文本 → Embedding 模型 → 向量 → 存入向量数据库。同时可能存储一些元数据,比如时间戳、来源、类型等。
🔹第二步:记忆的提取(Retrieval)—— 在正确的时间,想起正确的事
当用户输入新请求时,Agent 的思考流程:
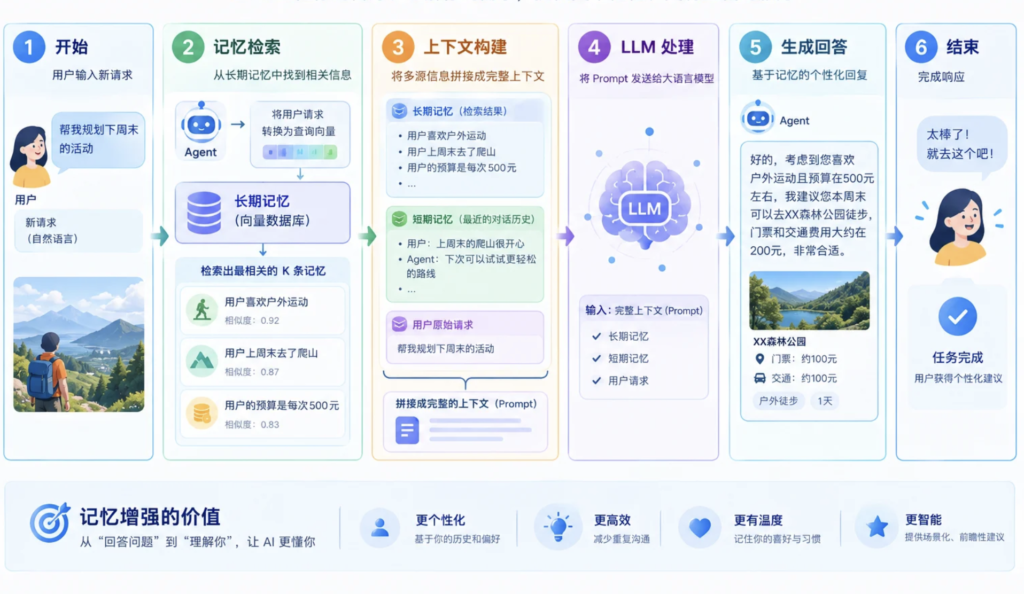
看到了吗?长期记忆并不是直接用来回答问题的,而是作为 “背景材料” 被动态 “注入” 到短期记忆中辅助 LLM 思考。这就是短期记忆和长期记忆的协同关系。
这个提取过程也有很多可以优化的点,比如:
- 混合搜索:除了向量的语义搜索,也结合传统的关键词搜索,确保精准度;
- 重排(Re-ranking):初步检索出 20 条相关记忆,再用一个更精细的模型对这 20 条进行排序,选出最终的 Top 5,提高相关性。
🔹第三步:记忆的精炼(Reflection / Synthesis)—— 温故而知新
这是最高级的一步。顶级 Agent 不应该只是被动存储和提取记忆,还应该能主动反思和整理自己的记忆。这个过程叫反思(Reflection)。
Agent 可以在空闲时自动执行任务:
- 从向量数据库中提取一批原始记忆;
- 将这些零散的记忆喂给 LLM,问:”根据这些记忆,能得出关于用户的什么新结论或更高层次的洞察?”;
- LLM 回答:”从用户最近多次询问 Python 语法和工具来看,用户目前正在积极学习 Python 编程”;
- Agent 把这个新生成的、高度概括的洞察型记忆也转换成向量存回长期记忆库;
这个过程把大量低价值的、零散的记忆提炼成了少量高价值的、结构化的知识。下次用户再问相关问题时,Agent 可以直接检索到 “用户正在学习 Python” 这条核心洞察,而不是一堆零散的聊天记录。
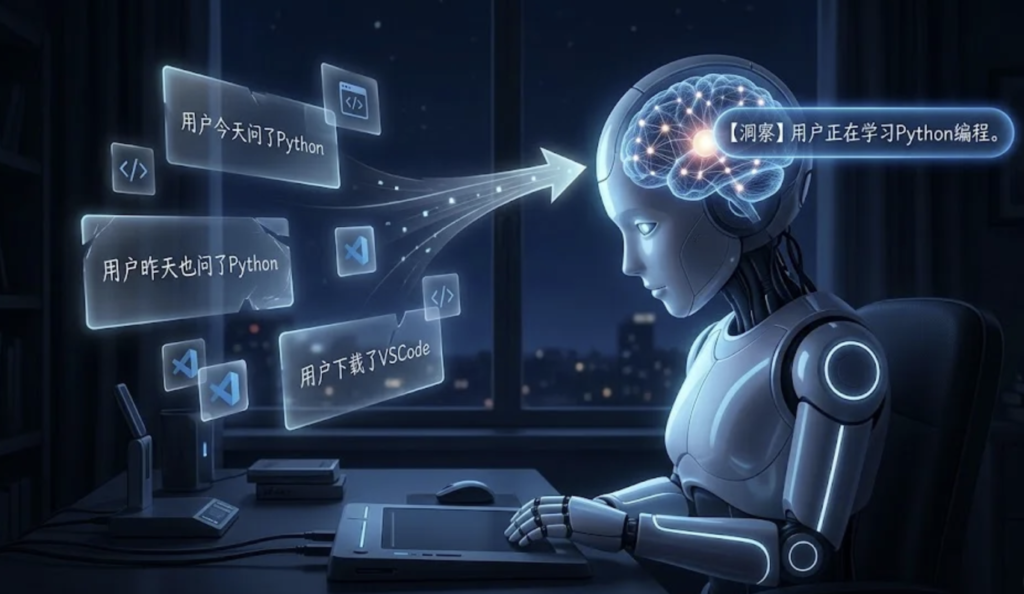
这就像人类不会记住每天的流水账,但会通过复盘总结出 “我最近好像对健身很感兴趣”、”我的工作效率在下午三点后会下降” 这样的规律。
一个具备了存入、提取、精炼这三步完整闭环的记忆系统,才算得上是一个真正意义上的学习型 AI Agent。
六、这些记忆用在哪了?—— 看看我们身边的实际案例 🔖
个性化 AI 助理
- 记忆内容:姓名、职业、兴趣爱好、人生目标、情绪状态;
- 应用:你跟它聊天时它记得你上次提到的那个烦人的项目终于结束了,让它推荐电影时会避开你讨厌的恐怖片类型。
智能客服 Agent
- 记忆内容:历史订单、过去的报修记录、和上一位客服的完整对话、已经尝试过的解决方案;
- 应用:你再也不用跟新客服重复 “我的订单号是 xxx,我遇到的问题是 xxx,我已经重启过八遍了”。新客服一上来就能说:“王先生您好,看到您关于订单 xxx 的问题,上次的同事已经记录了您尝试过重启,接下来我们试试 xxx 方法好吗”。
AI 编程助手
- 记忆内容:整个项目的代码库结构、每个文件的功能、你常用的编程范式和代码风格、项目依赖、Bug 修复历史;
- 应用:让它 “在用户模块里增加一个邮箱验证功能”,它不需要你告诉它用户模块在哪个文件,通过对整个代码库的记忆自己就能定位,写的代码也会和你现有的代码风格保持一致。
企业知识库问答 Agent
- 记忆内容:公司所有的内部文档、产品手册、培训资料、会议纪要;
- 应用:新员工可以直接问 Agent:“公司的报销流程是怎样的?我应该找谁审批?”Agent 会检索所有相关文档给出精准的综合答案。