转载:小红书 AI产品赵哥
一、我们为啥要 “折腾” 出模型蒸馏?—— 巨人的烦恼 🔖
我们正处在一个由 “大” 模型主导的时代。GPT‑4、Claude 3、Llama 3…… 它们的参数量动辄数千亿甚至万亿。它们强大、博学、能力惊人,但也带来了三个巨大的烦恼,我称之为 “巨人的三座大山”:
- 太大了 (Size):这些模型的文件大小通常是 GB 甚至 TB 级别。一个 GPT‑3(1750 亿参数)模型,存储下来就需要几百个 G。这别说放进手机了,就是下载都得下半天。
- 太慢了 (Latency):“大力” 真的会出奇迹,但 “大力” 也意味着 “慢”。你每次向 ChatGPT 提问,背后都有成百上千块顶级 GPU(比如 NVIDIA 的 A100 或 H100)在为你疯狂计算。即便如此,你还是能感觉到那零点几秒到几秒的延迟。如果要把这种计算量放到你的手机上,可能你问个问题,手机烫得能煎鸡蛋了,答案还没出来。
- 太贵了 (Cost):贵,体现在两个方面。一是训练成本,训练一次顶级大模型的成本是数百万甚至上千万美元。二是推理(使用)成本,你每次调用 API,背后烧的都是实打实的电费和计算资源费。对于企业来说,如果每个用户请求都要动用一个庞大的模型,那成本将是天文数字。
这三座大山,直接导致了强大的 AI 能力被困在了云端的 “象牙塔” 里。我们渴望 AI 能无处不在 —— 在没有网络的山里也能实时翻译,在你的智能手表上就能运行私人健康助手,在汽车里就能实现超低延迟的语音交互。
于是,一个天才的想法诞生了:我们能不能保留巨人(大模型)的智慧,但只拥有一个普通人(小模型)的体格?
模型蒸馏,就是实现这个想法的魔法。
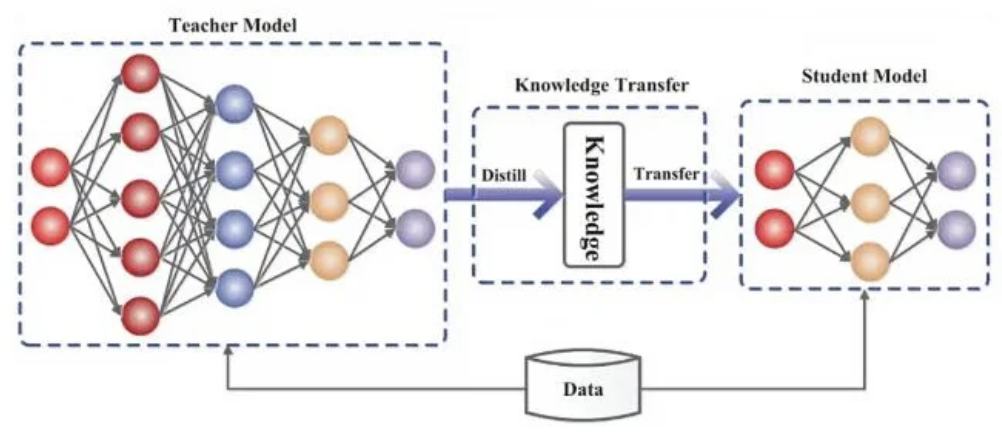
二、一个生动的比喻 ——“老师” 带 “学生” 🔖
为了彻底搞懂模型蒸馏,我们先来构建一个贯穿全文的比喻场景:
- 教师模型 (Teacher Model):想象一位学究天人、博古通今的大学教授。他就是我们的大模型。他知识渊博,解题能力顶级,但也有点 “养尊处优”—— 需要豪华的办公室(顶级服务器),思考问题慢条斯理(高延迟),而且出场费极高(高成本)。
- 学生模型 (Student Model):这是一位天资聪颖、反应敏捷的大一新生。他就是我们的小模型。他结构简单、学习能力强,能适应各种艰苦环境(比如在手机芯片上运行),但他初始时知识储备几乎为零,像一张白纸。
模型蒸馏的核心过程,就是让这位 “学神教授” 放弃传统的填鸭式教学,转而为这位 “潜力新生” 开设一门信息量爆炸的、手把手的私教课。
三、蒸馏的 “知识精髓” 是什么?—— 不仅仅是标准答案 (划重点!) 🔖
这是模型蒸馏最核心、最精妙的地方!
🔹 我们先看看传统的训练方式(填鸭式教学):
我们给模型一张猫的图片,然后告诉它,这张图对应的正确答案是 “猫”,标签是[0, 0, 1, 0](假设 “猫” 是第三类)。模型的目标就是学会在看到这张图时,无限逼近这个 “非黑即白” 的标准答案。我们把这种只有唯一正确答案的标签,称为硬标签 (Hard Label)。
这种方式的问题在于,它丢失了大量有用的信息。比如,模型不知道 “猫” 在某些特征上其实和 “狗” 以及 “狐狸” 有点像。
🔹 现在,我们看看模型蒸馏的教学方式(私教课):
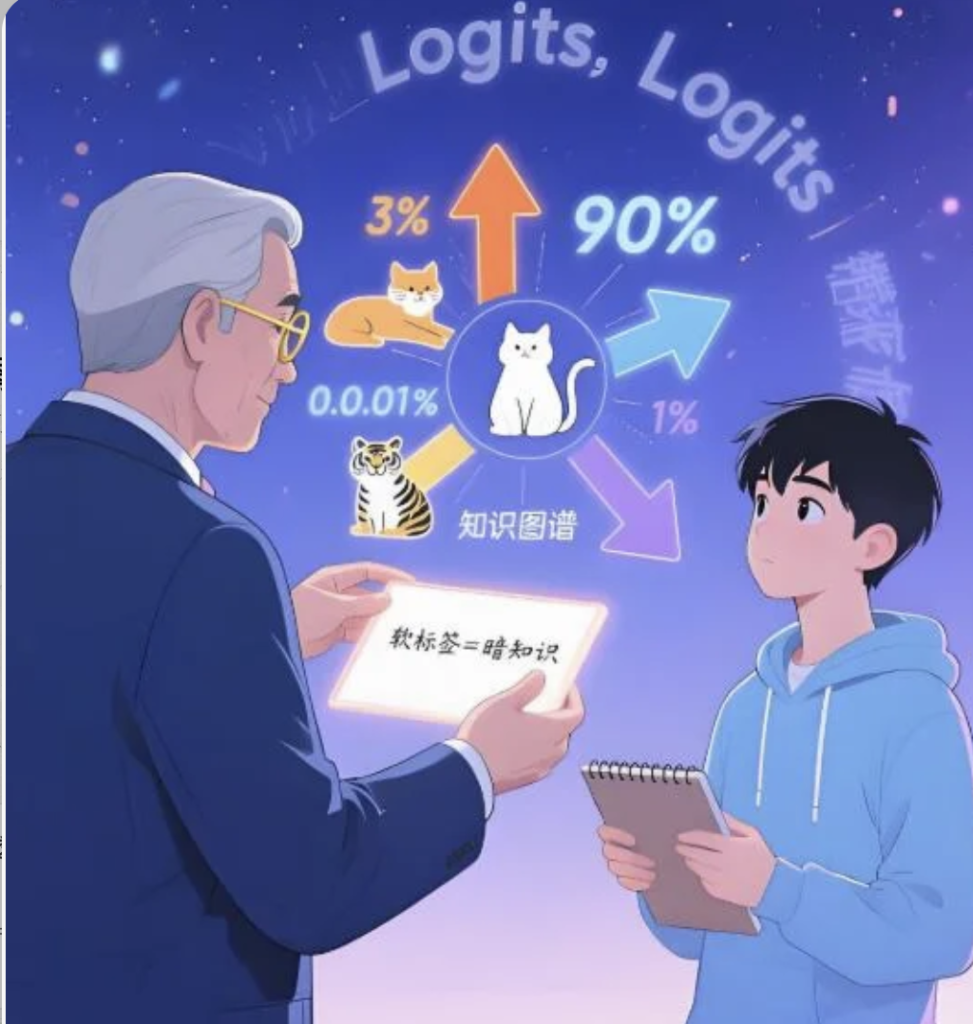
“教师模型”(学神教授)在看到这张猫的图片后,他不会直接告诉学生 “这是猫”。他会把他完整的 “思考过程” 展现给学生看。这个思考过程,在技术上通常指模型在输出最终答案前,那个未经处理的、包含了各种可能性的原始打分,我们称之为Logits。
为了让你好理解,我们把它想象成教授的内心独白:
“嗯… 根据我的知识库,我初步判断,这张图 90% 的可能性是猫🐱。但你看它那毛茸茸的耳朵,和某些小型犬种有 5% 的相似度🐶。而且,它那狡黠的眼神和尖尖的脸,又让我联想到了狐狸🦊,有 1% 的可能性。至于老虎🐯嘛,虽然都是猫科动物,但体型差异太大,可能性只有 0.01%…”
这个包含了[90% 猫, 5% 狗, 1% 狐狸, 0.01% 老虎, …]的、带有丰富概率分布信息的输出,就是软标签(Soft Label)。
软标签,就是被蒸馏的 “知识精髓”! 它蕴含了教师模型从海量数据中学到的、关于类别之间的相似性、关联性和细微差别的宝贵知识。这种知识,在硬标签里是完全不存在的,有时也被称为 “暗知识(Dark Knowledge)”。
四、学生如何学习?—— 从模仿答案到模仿思维 🔖
有了教师的 “软标签”,学生模型的学习目标就发生了根本性的转变。 它的任务不再是 “在看到猫图时,输出‘猫’”,而是变成了:
“在看到猫图时,我的思考过程(我的软标签),要和教师模型的思考过程(教师的软标签)尽可能地相似!”
学生要学习的,是教师的整个思维模式。它要去理解为什么老师会觉得猫和狗有 5% 的相似度,和狐狸有 1% 的相似度。通过拟合老师的软标签,学生模型被迫去学习那些更深层次、更泛化的特征。
这里再引入一个关键技术细节:温度(Temperature, T) 你可以把 “温度” 想象成一个 “思维发散旋钮”。在蒸馏时,我们通常会调高这个 “温度” 值。
- 温度低(T=1):教授的思维很 “冷静”,输出的概率会非常尖锐,接近于标准答案(比如 99.9% 是猫)。
- 温度高(T>1):我们给教授的思维 “加加温”,让他 “发散一下”。他的输出概率会变得更平滑、更 “软”(比如前面那个 90%,5%,1% 的例子)。这能让那些原本概率很小的类别(比如狗、狐狸)的信息也能被保留下来,让学生学到更丰富的知识。
所以,整个学习过程是:老师和学生都在一个较高的 “温度” 下进行思考和交流,课后再让学生自己把 “温度” 降下来,冷静地去应对真实世界的考试。
五、模型蒸馏好处?—— 浓缩的都是精华 🔖
经过这番精心教导,我们的 “学生模型” 顺利毕业了。它带来了什么惊人的变化呢?
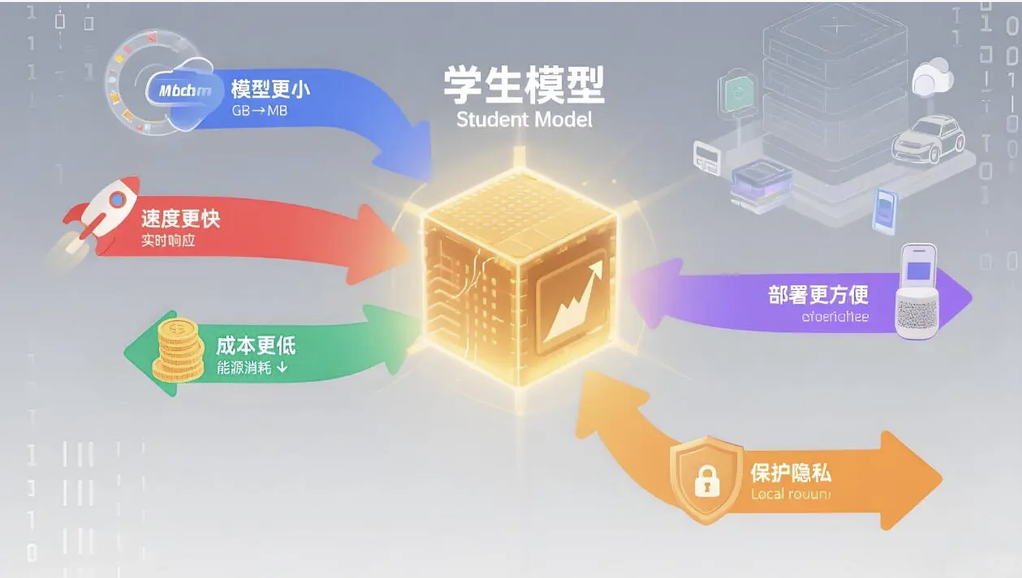
- ✅ 模型更小 (Smaller) 体积被急剧压缩。一个几十 GB 的教师模型,可以被蒸馏成一个只有几百 MB 甚至几十 MB 的学生模型。这是量级上的变化!
- ✅ 速度更快 (Faster) 因为模型结构简单、参数量少,学生模型的计算速度飞快。这对于需要实时响应的应用(如自动驾驶、实时语音助手)至关重要。
- ✅ 成本更低 (Cheaper) 无论是在云端部署还是在终端设备上运行,小模型消耗的计算资源和能源都呈指数级下降。这为 AI 技术的大规模普及铺平了道路。
- ✅ 部署更方便 (Edge‑friendly) 这可能是最重要的好处。小巧玲珑的学生模型可以被轻松地部署到各种边缘设备上,比如你的手机、汽车、无人机、智能音箱、VR/AR 眼镜等,让 AI 服务真正实现 “无处不在” 和 “随时可用”。
- ✅ 保护隐私 (Privacy‑preserving) 当模型可以在你的本地设备上运行时,你的个人数据就不需要上传到云端进行处理,极大地保护了用户隐私。
最不可思议的是,这个 “学生模型” 的性能,往往能达到 “教师模型” 95% 甚至更高的水平,并且远远超过一个同样大小、用传统方式从零开始训练的模型。真正实现了 “浓缩的都是精华”。
六、蒸馏方法的大家族 —— 不只有一种教法 🔖
我们上面讲的,是最经典的一种蒸馏方式(基于 Logits)。实际上,经过多年的发展,模型蒸馏已经演变成一个庞大的技术家族。教授教学生的方法也越来越丰富:
- 特征蒸馏 (Feature Distillation):教授不仅告诉学生最终的思考结果,还把他的 “草稿纸”(模型中间层的特征图 Feature Map)拿给学生看,让学生学习他的中间解题步骤。
- 关系蒸馏 (Relation Distillation):教授更进一步,教学生不同知识点之间的关联。比如,“猫” 和 “狗” 的关系,比 “猫” 和 “汽车” 的关系更近。学生要学习的是这种关系网络。
- 自蒸馏 (Self‑Distillation):这很有趣,老师就是学生自己。一个大模型先正常训练,然后它自己扮演老师,教一个和自己结构完全相同、但从零开始的学生模型。相当于 “今天的我” 教 “昨天的我”,通过这种方式也能实现性能提升。
- 在线蒸馏 (Online Distillation):不再是先有一个强大的老师,而是一群学生组成一个 “学习小组”,大家一起学习,互相扮演老师和学生,共同进步。
七、今日总结与回顾 🔖
好了,今天的硬核私教课就到这里。我们来快速回顾一下 “模型蒸馏” 的知识地图:
- 核心动机:解决大模型太大、太慢、太贵的 “三座大山”,让 AI 能走向边缘设备。
- 核心思想:知识迁移。让一个强大的 “教师模型”,将其学到的知识精髓传授给一个轻量的 “学生模型”。
- 核心技术:蒸馏 “软标签”(Soft Label),即教师模型完整的、包含丰富概率信息的 “思考过程”,而非 “硬标签” 的标准答案。
- 关键参数:温度(T),一个 “思维发散旋钮”,调高温度能让软标签包含更丰富的信息。
- 最终收益:得到一个更小、更快、更便宜、易部署,且性能依然强大的模型,是实现 AI 普惠的关键技术之一。