转载:小红书 AI产品赵哥
前言 🔖
在之前的笔记中,我们探讨了 AI 的各种神奇能力:它能写诗、能画画、能开车、能推理…… 我们一直在惊叹于它能做什么。
今天,我们来进行一次的溯源之旅,去回答那个根本的、核心的问题:这一切智能的背后,那个被称为神经网络(Neural Network,NN)的 AI 大脑,到底是如何工作的?
你可能听过很多关于它的描述:模仿人脑神经元、深度学习的基础、一个复杂的数学模型…… 这些描述都对,但都太抽象了!!!
为了理解神经网络,我们将抛开所有复杂的数学公式和代码,用一个极其简单的生活案例,一步步地、徒手搭建一个微型的神经网络。
你不需要任何编程或数学基础!只要跟着我的思路,耐心看完这篇笔记,你就能:
- 直观地理解神经元、权重、偏置、激活函数这些核心概念到底是什么。
- 亲眼见证一个神经网络是如何从一无所知,通过学习(训练),最终变得聪明起来的全过程。
- 彻底搞懂深度学习的深,到底深在哪里。
一、一切的开始 —— 像神经元一样做决策 🔖
在构建复杂的网络之前,我们先来认识一下它的最小、最基本的组成单位 ——神经元,也叫感知器 (Perceptron)。
别被名字吓到,它的工作方式,跟你做一次简单的决策,一模一样!
场景:你决定今天要不要带伞出门?
为了做这个决策,你的大脑会考虑几个输入信息:
- 天气预报说下雨的概率?(我们假设 0 代表 0%,1 代表 100%)
- 天空的乌云多不多?(0 代表晴空万里,1 代表乌云密布)
- 同伴有没有带伞?(0 代表没带,1 代表带了)
但是,这三个信息在你心中的权重 (Weight) 是不同的。
- 天气预报非常准,你非常信赖它,所以它的权重可能很高,比如6。
- 乌云也很重要,但不如预报准,权重可能是3。
- 同伴带没带伞,只是个参考,可能影响不大,权重可能是1。
现在,假设今天的情况是:
- 天气预报下雨概率是 0.8(80%)。
- 天空乌云密布,是 1。
- 同伴没带伞,是 0。
你的大脑会进行一次加权求和,计算一个带伞倾向分:
(输入1 × 权重1) + (输入2 × 权重2) + (输入3 × 权重3)
= (0.8 × 6) + (1 × 3) + (0 × 1)
= 4.8 + 3 + 0
= 7.8
这个 7.8 就是你内心想带伞的强烈程度。
最后,你需要一个决策门槛(Threshold)。比如,你设定只要这个倾向分大于等于 5,你就最终决定带伞。
因为 7.8 > 5,所以,最终决策:带伞!
恭喜你!你刚刚在脑中完成了一次人工神经元的完整计算!
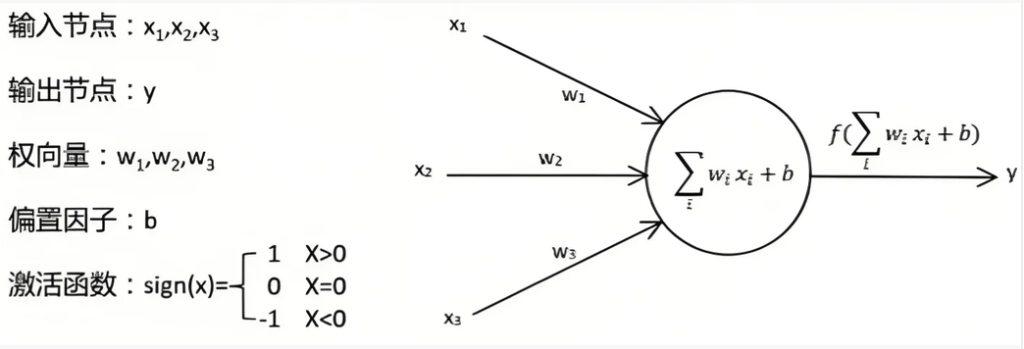
我们把它翻译成 AI 的语言:
- 输入(Inputs):x1,x2,x3(天气、乌云、同伴)
- 权重(Weights):w1,w2,w3(6,3,1)
- 加权和(Weighted Sum):z = x1*w1 + x2*w2 + x3*w3
- 决策门槛(Threshold):5
为了数学上更方便,我们通常会把门槛移到等式左边,变成一个偏置项(Bias, b)。 z – Threshold >= 0 等价于 z + (-Threshold) >= 0。我们令 b = -Threshold。
于是,公式变成了:z + b = x1*w1 + x2*w2 + x3*w3 + b
这里的偏置 (Bias),你可以理解为这个神经元天生的决策倾向。 一个 Bias 很大的神经元,就像一个天生就悲观、总想带伞的人,一点风吹草动就会让它激活。
最后一步,那个大于门槛就输出 1(带伞),小于就输出 0(不带伞)的决策过程,被称为激活函数(Activation Function)。它负责把前面计算出的倾向分,转化成一个最终的、明确的输出信号。
💡 一个人工神经元的完整工作流程就是: 接收多个输入 → 对每个输入乘以其对应的权重 → 将所有结果相加并加上一个偏置 → 将最终的和通过一个激活函数,得到输出。
二、从一个点到一张网 —— 神经网络的诞生 🔖
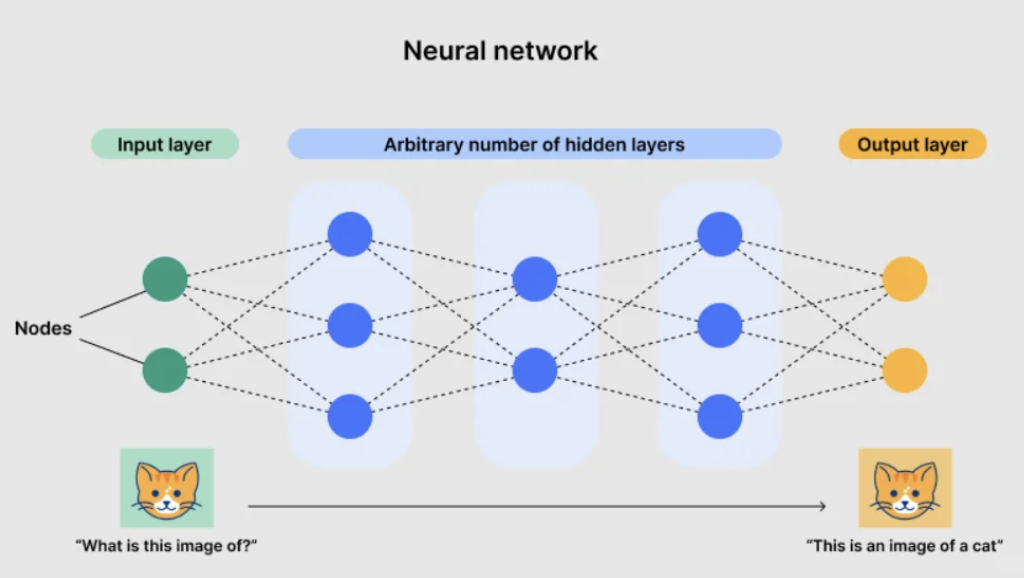
一个神经元只能做一个简单的线性决策,能力非常有限。但当我们把成千上万个这样的神经元,像搭乐高一样,组织成一张巨大的、层层相连的网络时,奇迹就发生了!
这就是神经网络。
一个最基础的神经网络,通常由三部分组成:
🔹 1. 输入层 (Input Layer):
- 职责:负责接收最原始的数据。
- 在我们的例子里:就是那 3 个代表天气、乌云、同伴的神经元。它有几个特征,输入层就有几个神经元。
🔹 2. 隐藏层 (Hidden Layer (s)):
- 职责:这是神经网络的最神奇的地方!它们位于输入层和输出层之间,负责对输入信息进行复杂的特征提取和组合。
- 为什么叫隐藏?:因为我们既不直接设置它的输入(它的输入来自上一层),也不直接看到它的输出(它的输出传递给下一层)。它就像一个黑箱,在内部进行着我们看不见的、复杂的计算。
- 在我们的例子里:我们可以设计一个包含 4 个神经元的隐藏层。这 4 个神经元,可能会在学习后,自发地学会识别一些更抽象的组合特征,比如:
- 神经元 H1:可能专门对高概率下雨且乌云密布这种强下雨信号组合,产生强烈的激活。
- 神经元 H2:可能专门对预报不准但乌云密布这种天气突变信号敏感。
- 神经元 H3:可能学会了识别社交信号(比如同伴带伞了)。
- 神经元 H4:可能在学习一些我们人类无法理解的、其他更复杂的特征组合。
🔹 3. 输出层 (Output Layer)
- 职责:负责输出最终的、我们想要的结果。
- 在我们的例子里:就是一个神经元,输出 1(带伞)或 0(不带伞)。如果是一个猫狗分类任务,输出层可能就有两个神经元,分别代表是猫的概率和是狗的概率。
🔹 这张网是如何连接的?
在一个最简单的全连接神经网络中,上一层的每一个神经元,都会与下一层的每一个神经元相连接。而每一条连接,都有它自己独立的权重 (Weight)!
想象一下,我们那个简单的例子,现在变成了一个 3-4-1 的网络(3 个输入,4 个隐藏,1 个输出):
- 从输入层到隐藏层,总共有 3 × 4 = 12 条连接,意味着有 12 个不同的权重。
- 从隐藏层到输出层,总共有 4 × 1 = 4 条连接,意味着有 4 个不同的权重。
- 再加上隐藏层和输出层每个神经元自己的偏置 (Bias)(4+1=5 个),整个网络需要学习的参数,就有 12 + 4 + 5 = 21 个!
这还只是一个玩具网络。像 GPT-3 这样的大模型,拥有 1750 亿个这样的参数!
三、AI 的学习本质 —— 寻找最佳权重组合的伟大旅程 🔖
我们已经搭建好了一个神经网络的骨架。但现在,它还是个空壳,因为里面所有的权重和偏置都是随机初始化的。它就像一个刚出生的大脑,里面空空如也,对任何问题都只会瞎猜。
那么,学习或训练的过程,到底是什么呢?
💡 划重点:
神经网络的学习,本质上就是一个参数优化的过程。即:通过不断地看标准答案,来一点点地、迭代地调整网络中成千上万个权重和偏置,直到整个网络对给定的输入,能够输出一个最接近标准答案的输出。
这个过程,就像一个蒙着眼睛的徒步者,要在一片连绵起伏的山脉中,找到海拔最低的那个山谷 ——最优解。
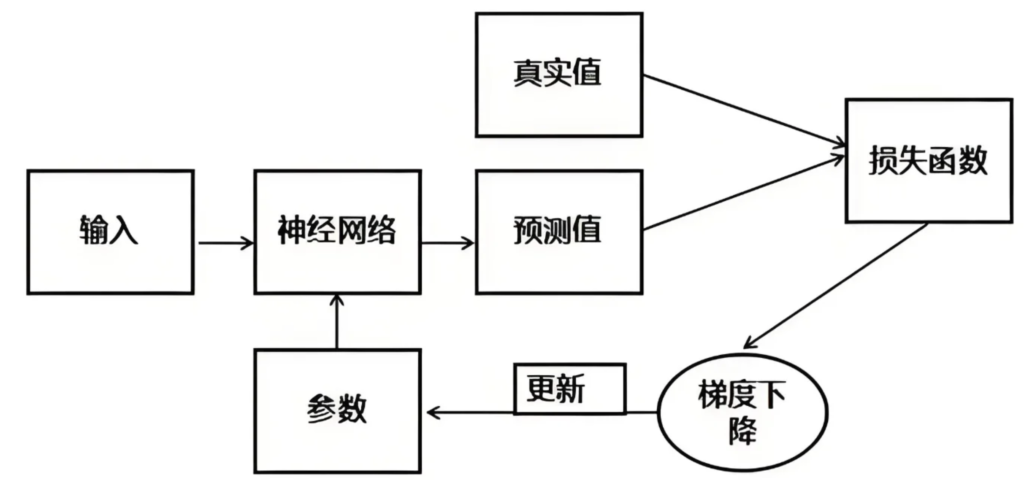
我们把下山过程,通常分为三步,循环往复:
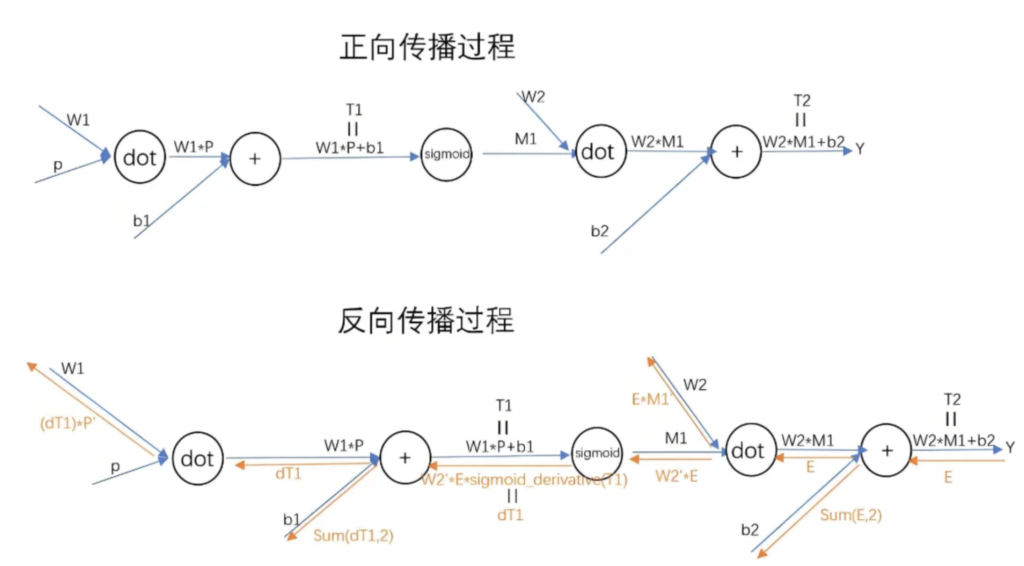
🔹 第一步:前向传播 (Forward Propagation) – 先猜一次
- 从我们的训练数据集(比如,10000 天真实的天气数据,以及当天是否带伞的正确标签)中,取出一小批数据(比如 32 天的数据)。
- 将第一天的数据(天气 = 0.7,乌云 = 0.9,同伴 = 1)输入到网络的输入层。
- 数据流过整个网络,从输入层到隐藏层,再到输出层。在每一层,每个神经元都进行我们前面讲的加权求和 + 激活函数的计算。
🔹 第二步:计算损失 (Calculate Loss) – 看看错得有多离谱
- 我们需要一个损失函数(Loss Function),也叫成本函数(Cost Function),来量化预测值和真实值之间的差距。
- 这个差距,就是损失(Loss),或者叫误差(Error)。差距越大,损失值就越高。
- 比如,我们可以用一个简单的均方误差函数:Loss = (真实值 – 预测值)² = (1 – 0.2)² = 0.64。
- 我们的终极目标,就是通过调整权重和偏置,让这个总的损失值变得尽可能小(接近 0)。
🔹 第三步:反向传播 (Backpropagation) & 梯度下降 (Gradient Descent) – 找到变聪明的方向
这是整个深度学习中最核心、最神奇的地方:
- 下山的智慧 —— 梯度下降
- 想象一下,你站在山坡上,想以最快的速度下到谷底。你应该怎么走?答案是:沿着当前位置最陡峭的那个方向,向下走一小步。
- 在数学中,这个最陡峭的方向,就是梯度(Gradient)。损失函数对于每一个权重和偏置的梯度,就告诉了我们:如果我把这个权重稍微调大一点点,最终的损失值会变大还是变小,以及变化的幅度有多大。
- 责任分配的艺术 —— 反向传播
- 问题来了,一个网络有几十亿个权重,我们怎么知道最终的那个总误差,应该由哪个权重来背锅呢?谁的责任大,谁的责任小?
- 反向传播 (Backpropagation) 算法,就是解决这个责任分配问题的天才发明。
- 它像一个精明的审计官,从输出层开始,一层一层地往回追溯。
- 它首先计算出输出层神经元的误差,应该由连接它的那些权重负多大责任。
- 然后,它根据这个责任,再往前推,计算出倒数第二层的神经元,应该为这个误差负多大责任。
- …… 如此层层递进,直到将这个总误差的责任,精确地、按贡献大小,分配到网络中的每一个权重和偏置上。
- 这个过程,利用了微积分中的链式法则,可以非常高效地计算出损失函数对所有参数的梯度。
- 更新参数
- 一旦我们知道了每个参数的梯度(即下山的方向),我们就可以沿着这个方向的反方向(因为我们要让损失变小),对参数进行一次微小的更新。
- 新权重 = 旧权重 – 学习率 × 梯度
- 这里的学习率 (Learning Rate),就是我们下山时,每一步走的步子有多大。步子太大了,可能会直接跨过谷底,跑到对面的山坡上;步子太小了,下山速度又会太慢。
这个前向传播 → 计算损失 → 反向传播 / 梯度下降 → 更新参数的过程,会重复进行成千上万次(我们称之为迭代)。
每一次迭代,网络里的参数都会朝着让总损失更小的方向,进行一次微调。
随着迭代的进行,神经网络就像一块被数据雕琢的璞玉,逐渐从一个随机的、混乱的状态,变得越来越有组织、越来越聪明,直到它能对我们给出的输入,做出越来越准确的判断。
这个从随机到有序的、寻找最优参数组合的过程,就是神经网络运转起来的全部过程。
四、深度的魔力 —— 从浅尝辄止到洞察本质 🔖
我们经常听到一个词 ——深度学习(Deep Learning)。它和我们刚才讲的神经网络是什么关系?
其实,深度学习,就是指使用了很深的神经网络的学习方法。
❓ 深是什么意思? 就是指网络中隐藏层的数量很多。我们之前那个 3-4-1 的网络,只有一个隐藏层,这是一个浅层网络 (Shallow Network)。而一个拥有几十、上百个隐藏层的网络,就是一个深度神经网络 (Deep Neural Network, DNN)。
❓ 为什么要追求深度?深,到底带来了什么魔力? 答案是:层次化的特征抽象。
一个深度网络,就像一个多级特征加工流水线。每一层,都在前一层提取出的特征基础上,进行更进一步的组合和抽象。
以一个识别猫的深度视觉网络(卷积神经网络,CNN)为例:
- 第一个隐藏层(最靠近输入图像):它可能只能学习到一些最最基础的、简单的特征,比如边缘、角点、颜色块。
- 第二个隐藏层:它会把第一层的零件(边缘、角点)组合起来,形成一些更复杂的特征,比如眼睛的轮廓、耳朵的尖角、鼻子的形状。
- 中间的隐藏层:它会继续组合,把眼睛、耳朵、鼻子组合成猫的脸部。
- 更深的隐藏层:它可能会把猫脸、猫爪、猫的身体轮廓这些高级特征组合起来,最终形成一个关于一只完整的猫的、极其抽象和鲁棒的内部表征。
深度,赋予了网络从像素到概念的、逐级抽象的能力。 这种层次化的学习方式,与我们人类的视觉认知系统极其相似,也正是深度学习之所以如此强大的根本原因。
一个浅层网络,可能只能学会把有胡须和有尖耳朵的动物识别为猫,这很容易被干扰。而一个深度网络,是真正理解了猫这个概念的层级化构成,因此它的识别能力要强大和泛化得多。
终极展望:从神经元到意识的漫漫长路 🔖
今天,我们从一个最简单的神经元,一步步搭建起了一个能够学习和思考的神经网络。
- 神经元是基本计算单元,通过权重和偏置进行决策。
- 神经网络通过分层和连接,获得了处理复杂问题的能力。
- 学习(训练)的本质,是通过反向传播和梯度下降,在海量数据中寻找最优的参数组合。
- 深度则通过层次化的特征抽象,赋予了网络洞察本质的强大力量。
我们今天所见证的所有 AI 奇迹,从本质上来说,都是这个基本思想的、在规模(更大的网络)、架构(更精巧的连接方式,如 CNN, RNN, Transformer—— 这些概念在后续的笔记中会讲到)和训练方法上进行极致演化的结果。
当然,我们也要清醒地认识到,目前的人工神经网络,虽然在功能上取得了巨大成功,但它与真正的人类大脑,在机制上仍然有着天壤之别。我们的大脑是低功耗、高效率,并且拥有意识和情感的奇迹。
从我们今天搭建的这个玩具大脑,到未来可能拥有真正意识的 AGI,依然是一条漫长、充满未知而又无比激动人心的道路。
五、总结一下吧 🔖
今天,我们进行了一场深入 AI 大脑内部的、史诗级的构建之旅。现在,让我们来总结一下核心要点:
- 神经网络是什么? 一个模仿人脑神经元连接结构,由大量人工神经元分层互联而成的计算模型。
- 神经元如何工作? 通过对输入信息进行加权求和,加上偏置,再通过激活函数,做出决策输出。
- AI 如何学习? 一个寻找最优参数(权重和偏置)的过程。通过前向传播(预测)→ 计算损失(评估错误)→ 反向传播 / 梯度下降(寻找优化方向)的循环,让模型的预测越来越接近真实答案。
- 深度的意义是什么? 层次化的特征抽象。深度网络能够从原始数据中,逐层提取出从简单到复杂的、越来越抽象的特征,从而获得强大的认知和泛化能力。
掌握了神经网络这个最底层的核心概念,你就拥有了理解所有上层 AI 技术(如大语言模型、计算机视觉)的第一性原理。你不再是一个只会使用 AI 的魔法师,而是一个开始理解魔法背后科学原理的炼金术士。