转载:小红书 AI产品赵哥
前言 🔖
最近圈子都在聊 FDE。有人说这是企业 AI 落地的终极答案,有人说是智商税。FDE 到底交付了什么?它能解决企业客户的真问题吗?作为资源有限的 OPC,我们又该怎么切入这条赛道?
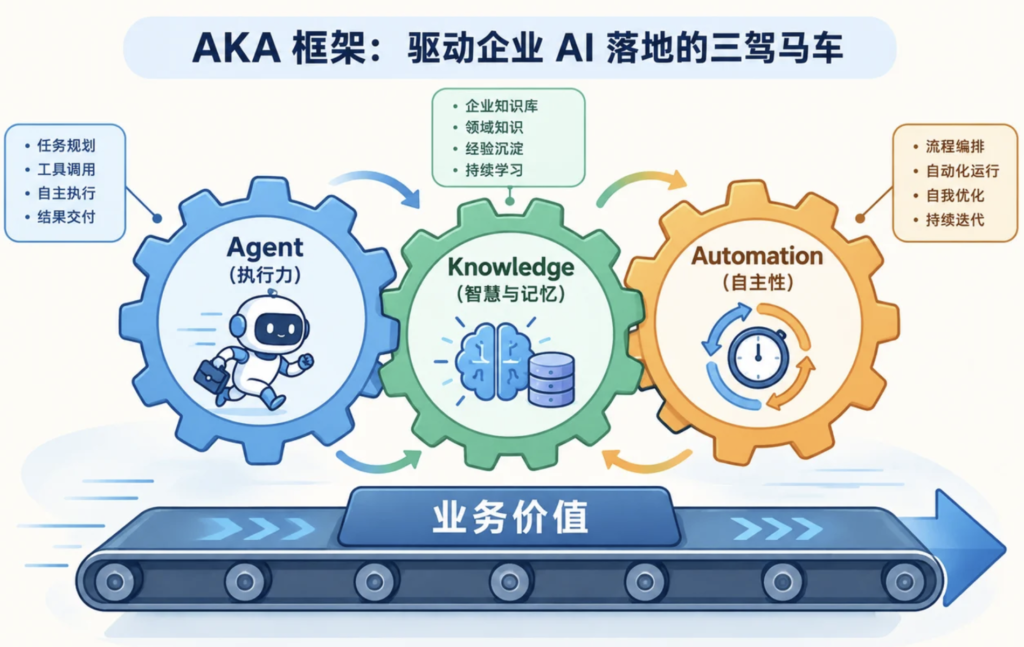
上半年,我以一人公司的形式,交付了几个 toB 的 AI 项目。前几天和几个同行吃饭,复盘了这半年踩过的坑。发现所有能让客户持续付费的 toB AI 项目,都符合一套标准 —— 我自己管它叫 AKA 框架。
今天咱来聊聊 AKA 框架,结合 OPC 的生存法则。进而挖掘 toB AI 项目的本质,看清 FDE 到底值不值得追。
AKA 框架三个要素:
- A – Agent:能帮你干活的 AI;
- K – Knowledge:让 AI 知道该干什么、怎么干;
- A – Automation:让 AI 自主执行,把人解放出来;
三个缺一不可。接下来咱来一一拆解。
一、A – Agent:那个能干活的 AI 🔖
这是 AKA 框架的手和脚。我们必须明确一个概念: 在企业级场景下,Agent ≠ Chatbot (聊天机器人)。
像豆包、文心一言这类 Chatbot,你跟它聊聊天、获取一些通用信息还行。但如果你想让它帮你干点具体的、嵌入你业务流程的活儿,比如 “去我的企业微信后台,把上周新增的客户线索,整理成一份 Excel 表发给我”,它就无能为力了。
一个合格的 toB Agent,必须具备动手能力。
那么,作为 OPC,我们该如何选择或构建这个 “能干活的 AI” 呢?我们面临两个选择:自建 Agent,还是基于成熟的 Agent 平台(如 WorkBuddy、Codex)进行二次开发。
🔹 1.1 自建 Agent 的陷阱
除非你有极其强大的开发能力,或者客户有极其严苛的、与世隔绝的本地化隐私要求,否则,我强烈不建议 OPC 一上来就走自建 Agent 的路。
Why?
- 成本与价值的不匹配:你辛辛苦苦花了两个月,自建了一个 Agent。客户用完后,很可能一个问题让你哑口无言:“你这个,跟我用 WorkBuddy,有什么本质区别吗?” 你会发现,你 80% 的工作,都是在重复造轮子,而客户并不为此买单。
- 生态与适配的巨大鸿沟:成熟的 Agent 平台,拥有庞大的插件市场 (Plugin Market)和专家生态。它们已经帮你做好了与各种主流办公软件(如飞书、企业微信)的连接器(MCP)。
- 比如,WorkBuddy 可以通过插件,直接在你的飞书群里帮你处理审批、自动回复消息。而你要自建,光是研究飞书的开放平台 API,就得花上半个月。
- 再比如,微信最近推出了 AI 银行卡,WorkBuddy 很快就能通过插件市场,接入类似美团生活助手这样的专家,你可以让 Agent 帮你点外卖。这种生态的力量,是你一个人无论如何也无法比拟的。
- 政企市场的准入壁垒:当你面对政府、国企这类客户时,这个问题会更突出。我们曾经遇到一个项目,需要在某卫健委的统信系统上部署 Agent。我们自研的 Agent 根本装不上,而像 WorkBuddy 这样的平台,因为有大厂的背书和专门的适配团队,甚至能搞定鸿蒙系统的适配。在这些场景下,“你打不过,就只能加入”,是唯一的现实选择。
🔹 1.2 OPC 的明智之选
拥抱成熟的 Agent 平台,把它们当作你的操作系统或开发框架,然后在上面构建你独特的业务价值。这就像你开发一个 App,你不会去自己写一个操作系统,而是会选择在 iOS 或 Android 上进行开发。
你需要向客户讲清楚:我们选择 WorkBuddy,不是因为我们偷懒,而是因为它提供了最稳定、最安全、生态最丰富的底座。我的核心价值,不在于重新发明这个底座,而在于利用这个强大的底座,为你量身定制解决你业务问题的上层应用 —— 也就是接下来的 K 和 A。
二、K – Knowledge Base & Database:AI 的大脑与记忆 🔖
这是 AKA 框架的核心。你已经有了一个能干活的 Agent,但如果你不给它提供 “工作的知识和方法”,它就是一个有手有脚但没有大脑的行尸走肉。
知识在企业场景下,分为两种:非结构化的知识 (Knowledge Base) 和 结构化的知识 (Database)。
🔹 2.1 知识库 (Knowledge Base):非结构化的经验手册
知识库,主要处理的是那些文本化、描述性的信息。通常,我们会用 Markdown 格式来组织这些知识,因为它简洁、清晰、易于 AI 理解。
【案例解析:我自己的 AI 博主选题库】 我在做 AI 博主时,积累了大量的选题灵感和写作经验。我把这些,都整理成了一个知识库,喂给了我的写作 Agent。
这个知识库⾥,不仅是纯文本,它包含了我的方法论。比如,一篇关于 “锐评国内大模型” 的选题,我不会只写标题。我会用 Markdown 表格,定义清楚它的属性:
| 属性 | 值 |
|---|---|
| 内容形式 | 文章 / 短视频 / 图文 |
| 紧急程度 | P0 (必须马上跟) / P1 / P2 |
| 内容进度 | 灵感 / 选题 / 大纲 / 写作中 / 已发布 / 放弃 |
| 选题类型 | 热点 / 教程 / 科普 / 测评 |
| 难度周期 | < 5 小时 / 1 天 / 1 周 |
| 目标受众 | 小白 / 进阶用户 / 开发者 |
| 内容目标 | 流量曝光 / 信任积累 / 引流转化 |
我把这些《经验手册》喂给 Agent 之后,它就学会了我的套路。
【知识库的高阶玩法:Skill + Knowledge】 知识库还可以和 Agent 的技能 (Skill)结合,产生更强大的化学反应。
比如,我做视频需要大量的封面图。我把过去所有我自己的照片,以及那些在网上火了的视频封面,一起喂给 AI,让它去分析,总结出“如何制作一张有张力的、高点击率的封面”的方法论,并把这个方法论,固化成一个名为 generate_cover_image 的 Skill。
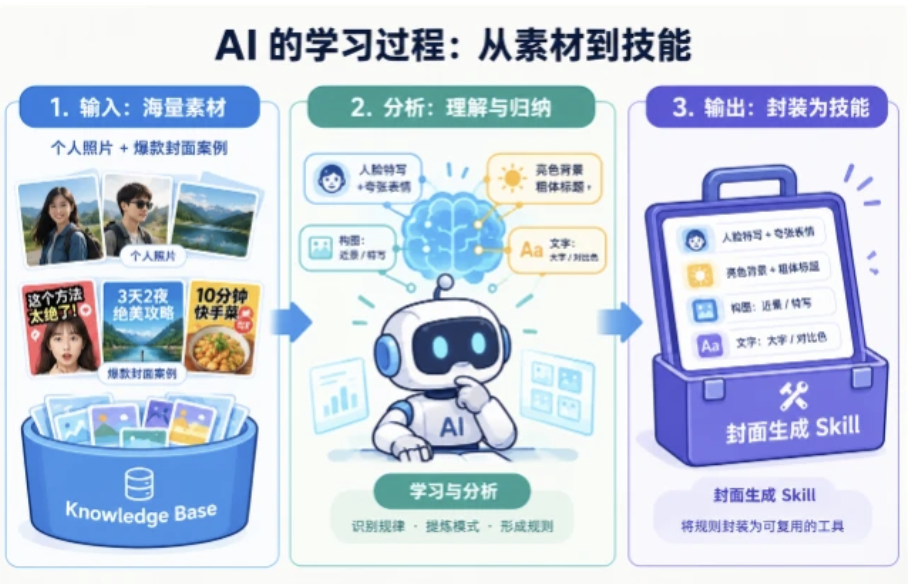
现在,当我需要做封面时,我只需要给 Agent 一个标题,比如 “6000 字讲透 Agent 架构”,它就会自动调用这个 Skill,并融合它学到的 “爆款方法论”,一次性生成三张风格各异、但都很有网感的备选封面,供我选择。
🔹 2.2 数据库 (Database):结构化的事实与关系
如果说知识库是经验,那么数据库就是事实。纯靠知识库是不够的,很多业务场景,都依赖于结构化的、有严格关系的数据。
我们之前提到的 “电商差评分析” 案例,就是一个很好的例子。
- “用户 A 购买了 B 商品,在 C 时间提交了差评”—— 这是一个事实,它必须以结构化的形式,存储在数据库中(比如一个
reviews表)。 - 情感分析的结果(差评属于 “物流类”)和处理状态(“已回复”、“已退款”),也应该作为新的字段,更新到这个数据库记录中。
只有这样,Agent 才能做到:
- 精准查询:比如,帮我筛选出所有关于 “B 商品” 的、属于 “质量问题” 的差评。
- 数据统计:比如,统计一下上周,”物流类” 差评的数量,并生成一个饼图。
- 状态追踪:比如,确保每一个差评,都有一个明确的、最终的处理状态,避免遗漏。
作为 OPC,当你面对一个 toB 项目时,一定要花大量时间,去和客户一起,梳理清楚他们的业务中,哪些是“经验知识”,哪些是“结构化事实”。然后,为他们设计一个“知识库 + 数据库”相结合的解决方案。这也是我们前面提到的“帮客户扫屋子”的核心工作。
三、A – Automation:AI 的自主运转引擎 🔖
这是实现“少雇一个人”这个目标的关键。有了能干活的 Agent(A),也有了可供参考的知识(K),但如果每一次,都需要你人工手动去触发 Agent,那这还是没有自动驾驶的老笨车。我们的目的,是让 AI 能够自主地、在无人干预的情况下,完成那些重复的工作。
自动化的演进,大致经历了三个阶段:
🔹 3.1 阶段一:RPA (Robotic Process Automation)
最早的自动化,叫 RPA。它就像一个按键精灵,你预先录制好一套固定不变的鼠标点击和键盘输入步骤,然后让它重复执行。
【案例解析】 比如,你要每天去自媒体后台,下载前一天的运营数据。 RPA 的逻辑是:
- 第一步:点击浏览器书签,打开抖音创作平台。
- 第二步:在页面坐标 (x1, y1) 的位置,点击【数据中心】按钮。
- 第三步:在页面坐标 (x2, y2) 的位置,点击【内容数据】。
- 第四步:点击日期选择器,选择【昨天】,然后点击【下载报表】。
⚠️ RPA 的问题:它很脆弱。只要抖音的网页改了一点点版,按钮的位置变了,整个自动化流程就会立刻失效。
🔹 3.2 阶段二:Workflow(工作流)- 可视化的流程编排
为了解决 RPA 的脆弱性,出现了像 n8n, Zapier 这样的 Workflow 工具。它们把自动化的逻辑,从 “模拟点击”,升级到了API 调用和逻辑编排。
你不再需要关心按钮在哪,而是通过拖拽组件,来搭建一个可视化的流程图。
“当抖音有新的数据报表生成时 (触发器),就调用飞书的 API,把报表发送到运营数据群里 (动作)。”
⚠️ Workflow 的问题:虽然比 RPA 强大得多,但对于非技术人员来说,它的学习曲线依然很陡峭。那些复杂的逻辑判断、数据转换,还是需要你有一定的编程思维。
🔹 3.3 阶段三:Skill + Goal(技能 + 目标)- 自然语言驱动
这是当前 Agent 领域正在发生的、最兴奋的变革。我们不再需要去编排流程,而是直接用自然语言,告诉 Agent “我要什么 (Goal)”,以及“我平时是怎么做的 (Skill)”。
剩下的所有事情 —— 如何理解任务、如何拆解步骤、如何调用工具、如何处理异常 —— 都由 Agent 自主完成。
【自动化演进公式】
我们得出了一个很牛掰的公式:
💡 Skill + Goal + Schedule = Autonomous Loop (技能 + 目标 + 定时器 = 自主循环)
我把这个公式,应用到我们最初的“自动化社交媒体运营”案例中:
- Skill(技能):我们已经通过前面的工作,把 “分析数据”、”结合热点”、”生成文案”、”生成图片”、”发布内容” 这些步骤,封装成了一个或多个可被 Agent 调用的 Skill。
- Goal(目标):我们给 Agent 下达一个明确的、最高阶的目标:
你的目标是,作为我们公司的社交媒体运营官,每周为 "智能咖啡机" 这个产品,创作并发布 3 篇高质量的小红书风格图文笔记。
- Schedule(定时器):我们给 Agent 设置一个定时任务:
请在每周一的早上 9:00,自动触发上述目标。
完成了这三步的配置,一个真正的 “自主运营 Agent”,就诞生了。
从现在开始,你完全可以解雇掉那个负责每周写推文的实习生了。这个 Agent,会像一个不知道累、且一直在线的员工,每周一准时开工,完成从选题到发布的全部流程,并将最终结果汇报给你。
而你,作为 OPC,你的工作,从执行者,变成了管理者和优化者。你只需要定期去 Review Agent 的工作成果,然后优化它的 Skill 和 Knowledge,让它的表现越来越好。
四、OPC 的 FDE 之路 🔖
现在,我们再回头看开篇的那个问题:FDE 是不是 OPC 的终极解法?
我的答案是:是,但不是我们传统意义上理解的那种 FDE。
作为 OPC,我们的全栈,不应该是去从零开始,重新发明 Agent 框架、重新去对接所有平台的 API、重新去写底层的自动化引擎。这条路,我们无论是资源、时间还是精力,都耗不起。
OPC 的新 FDE,是一种整合式的全栈能力。 我们的核心价值在于:
- 深刻理解客户的业务:能和客户一起,梳理清楚他们混乱的流程和数据,这是所有工作的基础。
- 熟练驾驭成熟的 AI 平台:能把 WorkBuddy 这样的平台玩得炉火纯青,知道如何利用它的生态和能力,来快速搭建应用。
- 精心构建知识资产:能为客户打造出那套独一无二的、结合了知识库与数据库的大脑。
- 巧妙设计自动化飞轮:能将 Skill + Goal + Schedule 组合起来,为客户创造出能自主运转的业务价值,把人解放出来。